Инструменты
Каталог TGAds
Мониторинг
Детальная статистика
Анализ аудитории
Бот аналитики
Полезная информация
Инструкция Telemetr
Документация к API
MCP для ИИ-ассистента
Чат Telemetr
Не попадитесь на накрученные каналы! Узнайте, не накручивает ли канал просмотры или
подписчиков
Проверить канал на накрутку


Телеграм канал «Blondy Chain - CRYPTO»

Blondy Chain - CRYPTO
8.1K
36.3K
1.8K
87
67.3K
💛 https://linktr.ee/blondychain - проверить все ссылки! 💛
🚀 Мой чат : telemetr.me/blondychain
🚀 Мой канал: telemetr.me/blondychain_announce
🚀 Мой Youtube - https://cutt.ly/xIQ37K9
🚀 Мой чат : telemetr.me/blondychain
🚀 Мой канал: telemetr.me/blondychain_announce
🚀 Мой Youtube - https://cutt.ly/xIQ37K9
Подписчики
Всего
6 915
Сегодня
0
Просмотров на пост
Всего
212
ER
Общий
3.07%
Суточный
1.71%
Динамика публикаций

Telemetr - сервис глубокой аналитики
телеграм-каналов
телеграм-каналов

Получите подробную информацию о каждом канале
Отберите самые эффективные каналы для
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам

Анализируйте рекламные посты
и креативы
и креативы
Узнайте какие посты лучше сработали,
а какие хуже, даже если их давно удалили
а какие хуже, даже если их давно удалили

Оценивайте эффективность тематики и контента
Узнайте, какую тематику лучше не рекламировать
на канале, а какая зайдет на ура
на канале, а какая зайдет на ура

Показано 7 из 8 098 постов
Смотреть все посты
Пост от 18.09.2026 15:08
33
1
2
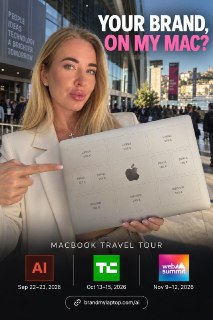
Схоже, мій MacBook тепер офіційно став медіакомпанією 😄
Я відкриваю 11 рекламних місць на його кришці на наступні 12 місяців.
👉 https://brandmylaptop.com/ai
І цей MacBook подорожуватиме разом зі мною та LILIDi AI:
🇪🇸 AI SUMMIT BARCELONA — 22–23 вересня
🇺🇸 TechCrunch Disrupt San Francisco — 13–15 жовтня
🇵🇹 Web Summit Lisbon — 9–12 листопада
А ще будуть зустрічі з інвесторами, вечері з фаундерами, аеропорти, кав’ярні, дзвінки та всі інші пригоди між цими подіями.
Ідея проста: ваш логотип їде туди, куди їду я.
Окремий респект Vincent Seube за те, що створив BrandMyLaptop, і Giulia de Oliveira Camargo за те, що показала: задня кришка MacBook, схоже, дуже недооцінений рекламний інвентар 😂
І дякую Giulia de Oliveira Camargo за саму ідею 💛
Я відкриваю 11 рекламних місць на його кришці на наступні 12 місяців.
👉 https://brandmylaptop.com/ai
І цей MacBook подорожуватиме разом зі мною та LILIDi AI:
🇪🇸 AI SUMMIT BARCELONA — 22–23 вересня
🇺🇸 TechCrunch Disrupt San Francisco — 13–15 жовтня
🇵🇹 Web Summit Lisbon — 9–12 листопада
А ще будуть зустрічі з інвесторами, вечері з фаундерами, аеропорти, кав’ярні, дзвінки та всі інші пригоди між цими подіями.
Ідея проста: ваш логотип їде туди, куди їду я.
Окремий респект Vincent Seube за те, що створив BrandMyLaptop, і Giulia de Oliveira Camargo за те, що показала: задня кришка MacBook, схоже, дуже недооцінений рекламний інвентар 😂
І дякую Giulia de Oliveira Camargo за саму ідею 💛
❤
1
🤯
1
Пост от 16.09.2026 18:56
23
0
1
Вересень видався просто шалено насиченим. 🚀
Попереду AI SUMMIT BARCELONA, а ще я отримала дуже цікавий грант від Crusoe 👀
Поки що не можу розкрити всі деталі, але ми використаємо GPU-кредити, щоб ще активніше розвивати LILIDi AI Twin — наших AI-співробітників для реальних розмов із клієнтами. Скоро розповім більше.
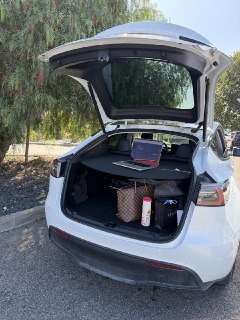
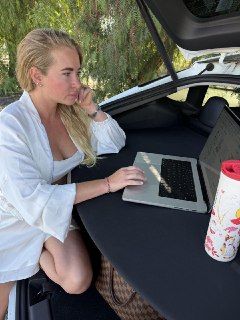
А поки багажник офіційно став моїм мобільним офісом 😂💻
У кого ще є такий «офіс на колесах»? І яке найдивніше місце, з якого вам доводилося працювати?
#Lilidi #LilidiTwin #AITwins #AIAgents #AI #Startup #FounderLife #BuildingInPublic #GPUs #AISummit #Barcelona
Попереду AI SUMMIT BARCELONA, а ще я отримала дуже цікавий грант від Crusoe 👀
Поки що не можу розкрити всі деталі, але ми використаємо GPU-кредити, щоб ще активніше розвивати LILIDi AI Twin — наших AI-співробітників для реальних розмов із клієнтами. Скоро розповім більше.
А поки багажник офіційно став моїм мобільним офісом 😂💻
У кого ще є такий «офіс на колесах»? І яке найдивніше місце, з якого вам доводилося працювати?
#Lilidi #LilidiTwin #AITwins #AIAgents #AI #Startup #FounderLife #BuildingInPublic #GPUs #AISummit #Barcelona
❤
2
🤯
1
🐳
1
Пост от 16.09.2026 12:44
17
0
1
🎨 MiniMax Design отримав велике оновлення — тепер це вже повноцінне креативне середовище з ШІ.
Замість окремої генерації зображень чи відео MiniMax поступово збирає весь творчий процес в одному workspace.
🤖 Одна з головних новинок — спільна робота кількох AI-агентів.
Різні агенти можуть паралельно працювати над одним проєктом: один займається текстом, інший — візуалами, ще один — відео або аудіо, а потім усе об’єднується в єдиний результат.
🔗 Також з’явилися MCP-сценарії, які дозволяють зв’язувати різні інструменти та автоматизувати складніші креативні процеси.
🧊 MiniMax Design розширюється і в бік професійного софту — з підтримкою workflow навколо Blender, Photoshop та After Effects.
До процесу додається й робота з 3D, тому в одному середовищі можна поєднувати 3D-асети, зображення та відео.
🎬 Для генерації відео всередині платформи доступна MiniMax H3, тож відеогенерація стає ще одним етапом загального production workflow.
Схоже, MiniMax хоче зробити не просто набір AI-генераторів, а повноцінний командний центр, де креатор керує агентами, моделями та професійними інструментами з одного місця.
#MiniMax #MiniMaxDesign #ШІ #AIAgents #GenerativeAI #CreativeAI #Blender #AfterEffects #VideoAI #НовиниШІ
Замість окремої генерації зображень чи відео MiniMax поступово збирає весь творчий процес в одному workspace.
🤖 Одна з головних новинок — спільна робота кількох AI-агентів.
Різні агенти можуть паралельно працювати над одним проєктом: один займається текстом, інший — візуалами, ще один — відео або аудіо, а потім усе об’єднується в єдиний результат.
🔗 Також з’явилися MCP-сценарії, які дозволяють зв’язувати різні інструменти та автоматизувати складніші креативні процеси.
🧊 MiniMax Design розширюється і в бік професійного софту — з підтримкою workflow навколо Blender, Photoshop та After Effects.
До процесу додається й робота з 3D, тому в одному середовищі можна поєднувати 3D-асети, зображення та відео.
🎬 Для генерації відео всередині платформи доступна MiniMax H3, тож відеогенерація стає ще одним етапом загального production workflow.
Схоже, MiniMax хоче зробити не просто набір AI-генераторів, а повноцінний командний центр, де креатор керує агентами, моделями та професійними інструментами з одного місця.
#MiniMax #MiniMaxDesign #ШІ #AIAgents #GenerativeAI #CreativeAI #Blender #AfterEffects #VideoAI #НовиниШІ
Видео/гифка
❤
1
👍
1
🔥
1
Пост от 14.09.2026 14:22
41
1
1
🎙 Tencent відкрила AuK — універсальну ШІ-модель для генерації та редагування голосу.
AuK — це foundation-модель на 1,5 млрд параметрів, яка об’єднує одразу кілька задач роботи з аудіо та керується звичайними текстовими командами.
🔊 Модель може:
• клонувати голос за прикладом
• генерувати мовлення за текстовим описом
• змінювати слова у вже готовому записі
• редагувати емоцію, тембр, швидкість і висоту голосу
• очищувати аудіо від шумів
• розділяти кількох спікерів
• виконувати інші трансформації мовлення
Замість використання кількох окремих сервісів достатньо просто описати, що саме потрібно зробити з голосом або записом.
⚡️ Окремо Tencent випустила AuK-Flash — прискорену версію, яка використовує лише 4 кроки inference.
Це робить модель цікавою не лише для експериментів, а й для локальних інструментів та застосунків, де важлива швидкість роботи.
💻 Код і ваги AuK уже доступні публічно під MIT-ліцензією, тому модель можна запускати локально, модифікувати та інтегрувати у власні продукти.
Схоже, voice AI поступово рухається від набору окремих інструментів до універсальних моделей, які можуть одночасно генерувати, редагувати й трансформувати аудіо.
#Tencent #AuK #ШІ #VoiceAI #SpeechAI #AudioAI #OpenSourceAI #GenerativeAI #НовиниШІ
AuK — це foundation-модель на 1,5 млрд параметрів, яка об’єднує одразу кілька задач роботи з аудіо та керується звичайними текстовими командами.
🔊 Модель може:
• клонувати голос за прикладом
• генерувати мовлення за текстовим описом
• змінювати слова у вже готовому записі
• редагувати емоцію, тембр, швидкість і висоту голосу
• очищувати аудіо від шумів
• розділяти кількох спікерів
• виконувати інші трансформації мовлення
Замість використання кількох окремих сервісів достатньо просто описати, що саме потрібно зробити з голосом або записом.
⚡️ Окремо Tencent випустила AuK-Flash — прискорену версію, яка використовує лише 4 кроки inference.
Це робить модель цікавою не лише для експериментів, а й для локальних інструментів та застосунків, де важлива швидкість роботи.
💻 Код і ваги AuK уже доступні публічно під MIT-ліцензією, тому модель можна запускати локально, модифікувати та інтегрувати у власні продукти.
Схоже, voice AI поступово рухається від набору окремих інструментів до універсальних моделей, які можуть одночасно генерувати, редагувати й трансформувати аудіо.
#Tencent #AuK #ШІ #VoiceAI #SpeechAI #AudioAI #OpenSourceAI #GenerativeAI #НовиниШІ
Видео/гифка
❤
3
🔥
3
👍
3
🍌
2
Пост от 14.09.2026 11:19
78
1
1
💥 Synthesia представила Express-3 — свою найпросунутішу модель AI-аватарів
Synthesia випустила Express-3 — нове покоління технології AI-аватарів із більш природною поведінкою та швидшою генерацією відео.
⚡️ Генерація тепер працює до 2× швидше.
🎭 Express-3 враховує емоційний тон тексту, тому аватар може природніше адаптувати свою подачу до настрою сценарію.
👄 Також покращили lip sync, рухи тіла та жести персонажів.
🎨 На базі Express-3 працюють нові Style Avatars — стилізованих персонажів можна створювати прямо з текстового промпту або готового пресету через Avatar Builder.
Підтримка reference images для Style Avatars з’явиться пізніше.
🚀 Express-3 уже доступна на всіх тарифах Synthesia.
AI-аватари стають швидшими, виразнішими та значно гнучкішими для різних стилів і форматів контенту.
#Synthesia #AI #AIVideo #GenerativeAI #AIAvatars #TechNews
Synthesia випустила Express-3 — нове покоління технології AI-аватарів із більш природною поведінкою та швидшою генерацією відео.
⚡️ Генерація тепер працює до 2× швидше.
🎭 Express-3 враховує емоційний тон тексту, тому аватар може природніше адаптувати свою подачу до настрою сценарію.
👄 Також покращили lip sync, рухи тіла та жести персонажів.
🎨 На базі Express-3 працюють нові Style Avatars — стилізованих персонажів можна створювати прямо з текстового промпту або готового пресету через Avatar Builder.
Підтримка reference images для Style Avatars з’явиться пізніше.
🚀 Express-3 уже доступна на всіх тарифах Synthesia.
AI-аватари стають швидшими, виразнішими та значно гнучкішими для різних стилів і форматів контенту.
#Synthesia #AI #AIVideo #GenerativeAI #AIAvatars #TechNews
❤
4
👍
4
🔥
4
Пост от 13.09.2026 12:26
133
0
1
💰 OpenAI запустила окремий ChatGPT для банків та інвестиційних компаній.
ChatGPT for Financial Services створений спеціально для фінансового аналізу, побудови моделей, дослідження компаній та підготовки матеріалів для клієнтів.
📊 Усередині одразу доступні дані з Daloopa, PitchBook, LSEG News і Crunchbase.
ChatGPT може аналізувати фінансову звітність, таблиці та примітки, порівнювати показники компаній за різні періоди та показувати джерело конкретної цифри.
📈 Тобто аналітик може не лише отримати короткий підсумок документа, а й працювати безпосередньо з фінансовими даними та перевіряти, звідки взята кожна цифра.
📁 Компанії також можуть підключати власні шаблони Excel, Word і PowerPoint.
Після цього система зможе створювати фінансові моделі, аналітичні звіти та презентації одразу у корпоративному форматі.
🤝 Продукт розробляли разом із Morgan Stanley та Evercore, щоб адаптувати ChatGPT до реальних робочих процесів фінансових компаній.
Поки що доступ відкритий лише для відповідних фінансових організацій.
Схоже, OpenAI поступово рухається від універсального ChatGPT до спеціалізованих AI-продуктів для окремих індустрій.
#OpenAI #ChatGPT #ШІ #FinTech #FinancialServices #FinanceAI #Інвестиції #НовиниШІ
ChatGPT for Financial Services створений спеціально для фінансового аналізу, побудови моделей, дослідження компаній та підготовки матеріалів для клієнтів.
📊 Усередині одразу доступні дані з Daloopa, PitchBook, LSEG News і Crunchbase.
ChatGPT може аналізувати фінансову звітність, таблиці та примітки, порівнювати показники компаній за різні періоди та показувати джерело конкретної цифри.
📈 Тобто аналітик може не лише отримати короткий підсумок документа, а й працювати безпосередньо з фінансовими даними та перевіряти, звідки взята кожна цифра.
📁 Компанії також можуть підключати власні шаблони Excel, Word і PowerPoint.
Після цього система зможе створювати фінансові моделі, аналітичні звіти та презентації одразу у корпоративному форматі.
🤝 Продукт розробляли разом із Morgan Stanley та Evercore, щоб адаптувати ChatGPT до реальних робочих процесів фінансових компаній.
Поки що доступ відкритий лише для відповідних фінансових організацій.
Схоже, OpenAI поступово рухається від універсального ChatGPT до спеціалізованих AI-продуктів для окремих індустрій.
#OpenAI #ChatGPT #ШІ #FinTech #FinancialServices #FinanceAI #Інвестиції #НовиниШІ
❤
4
👍
3
🔥
3
Пост от 12.09.2026 18:11
156
1
2
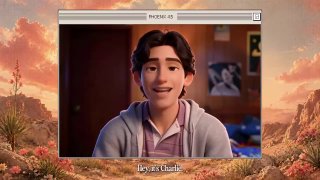
Tavus представила Phoenix-4.5 — ще реалістичнішу AI-людину в реальному часі
🔥 Tavus випустила Phoenix-4.5 — нову модель для генерації цифрових людей під час real-time розмов.
👤 Головне покращення — тепер на мовлення реагує не лише обличчя персонажа. Рухи голови, плечей, корпусу та міміка синхронізуються з тим, що говорить AI.
⚡️ Затримка між аудіо та відео становить близько 134 мс, тому персонаж може реагувати майже миттєво.
😮 Tavus також покращила передачу емоцій, міміку та природність рухів тіла.
Phoenix-4.5 працює разом з іншими моделями Tavus:
🧠 Raven-1 допомагає AI розуміти людину та навколишнє середовище.
🎙 Sparrow-2 відповідає за паузи, перебивання та ритм розмови.
🎥 Phoenix-4.5 перетворює все це на реакції цифрового персонажа.
AI-аватари поступово переходять від простих «говорячих облич» до персонажів, які можуть слухати, розуміти та реагувати в реальному часі.
#Tavus #AI #AIAgents #ConversationalAI #AIVideo #GenerativeAI
🔥 Tavus випустила Phoenix-4.5 — нову модель для генерації цифрових людей під час real-time розмов.
👤 Головне покращення — тепер на мовлення реагує не лише обличчя персонажа. Рухи голови, плечей, корпусу та міміка синхронізуються з тим, що говорить AI.
⚡️ Затримка між аудіо та відео становить близько 134 мс, тому персонаж може реагувати майже миттєво.
😮 Tavus також покращила передачу емоцій, міміку та природність рухів тіла.
Phoenix-4.5 працює разом з іншими моделями Tavus:
🧠 Raven-1 допомагає AI розуміти людину та навколишнє середовище.
🎙 Sparrow-2 відповідає за паузи, перебивання та ритм розмови.
🎥 Phoenix-4.5 перетворює все це на реакції цифрового персонажа.
AI-аватари поступово переходять від простих «говорячих облич» до персонажів, які можуть слухати, розуміти та реагувати в реальному часі.
#Tavus #AI #AIAgents #ConversationalAI #AIVideo #GenerativeAI
❤
3
🔥
3
👍
3