Не попадитесь на накрученные каналы! Узнайте, не накручивает ли канал просмотры или
подписчиков
Проверить канал на накрутку


Телеграм канал «Постоянный репозиторий по Python»
Подписчики
Всего
1 802
Сегодня
-1
Просмотров на пост
Всего
170
ER
Общий
9.45%
Суточный
5.99%
Динамика публикаций

Telemetr - сервис глубокой аналитики
телеграм-каналов
телеграм-каналов

Получите подробную информацию о каждом канале
Отберите самые эффективные каналы для
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам

Анализируйте рекламные посты
и креативы
и креативы
Узнайте какие посты лучше сработали,
а какие хуже, даже если их давно удалили
а какие хуже, даже если их давно удалили

Оценивайте эффективность тематики и контента
Узнайте, какую тематику лучше не рекламировать
на канале, а какая зайдет на ура
на канале, а какая зайдет на ура

Показано 7 из 389 постов
Смотреть все посты
Пост от 20.10.2026 10:20
2
0
0
🐼 Почему не стоит использовать циклы для обработки строк DataFrame
Одна из самых распространённых ошибок при работе с Pandas – попытка обрабатывать DataFrame так же, как обычный список.
Например, написать цикл по строкам и выполнять вычисления для каждой из них. Да, такой код будет работать. Но, скорее всего, он окажется значительно медленнее, чем мог бы быть.
В чём причина?
Pandas создавался для работы не со строками, а со столбцами.
Большинство его операций умеют обрабатывать сразу весь столбец целиком.
Например, если нужно увеличить цену на 10%, не нужно перебирать строки по одной.
Достаточно одной операции:
df["price"] = df["price"] * 1.1
И Pandas выполнит вычисление сразу для всех записей.
Почему это быстрее?
Когда вы пишете цикл, вычисления происходят на уровне Python.
Когда используете операции над столбцами, значительная часть работы выполняется внутри Pandas и NumPy, которые оптимизированы для подобных задач.
Именно поэтому разница в производительности может быть очень заметной.
Какой подход лучше?
Обычно рекомендуется придерживаться такого порядка:
Использовать встроенные методы Pandas.
Использовать операции над столбцами.
Использовать groupby(), merge(), query() и другие возможности библиотеки.
И только если другого варианта нет — переходить к циклам.
💡 Полезный совет
Если вы поймали себя на мысли:
«Сейчас напишу цикл по DataFrame...»
остановитесь на минуту и подумайте:
А можно ли решить эту задачу без цикла?
Очень часто ответ будет «да».
Именно этот переход – от обработки отдельных строк к обработке целых столбцов – считается одним из самых важных этапов в освоении Pandas.
Пост от 15.10.2026 10:09
129
0
0
Пост от 15.10.2026 10:09
128
0
0
Пост от 13.10.2026 07:18
117
0
0
🐼 Почему info() — одна из самых полезных команд в Pandas
Когда вы загружаете новый датасет, возникает соблазн сразу открыть первые строки:
df.head()
Это действительно полезно.
Но опытные аналитики почти сразу после этого выполняют ещё одну команду:
df.info()
Почему именно info()?
Всего одна команда позволяет за несколько секунд понять структуру всего датасета.
Она показывает:
- количество строк;
- количество столбцов;
- названия столбцов;
- тип данных каждого столбца;
- количество непустых значений;
- объём памяти, занимаемый DataFrame.
То есть вы сразу видите общую картину, не просматривая данные вручную.
Что можно обнаружить за минуту?
Очень часто info() помогает найти проблемы ещё до начала анализа.
Например:
✅ числовой столбец оказался строкой (object);
✅ часть данных отсутствует;
✅ даты не распознаны как даты;
✅ в таблице намного больше данных, чем ожидалось.
Все эти проблемы лучше заметить в самом начале, чем искать ошибки спустя несколько часов. Особенно полезно смотреть на типы данных
Допустим, столбец price хранится как object, а не как float.
Это может означать:
- в данных есть лишние символы;
- используется неправильный разделитель;
- встречаются некорректные значения.
Пока тип данных не исправлен, многие вычисления работать не будут.
💡 Полезная привычка
После чтения нового файла я обычно выполняю всего три команды:
df.head()
df.info()
df.describe()
Этого достаточно, чтобы за пару минут получить первое представление о данных и понять, в каком направлении двигаться дальше.
❤
3
🔥
1
💯
1
Пост от 08.10.2026 10:05
221
0
0
❤
1
👍
1
💯
1
Пост от 08.10.2026 10:05
209
0
0
❤
2
👍
1
🤝
1
Пост от 07.10.2026 11:41
2
0
0
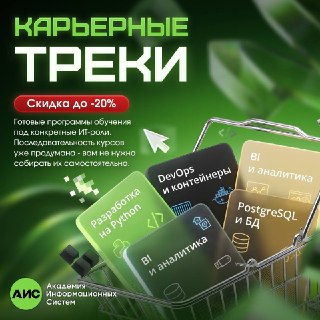
Карьерные треки АИС: готовые маршруты обучения со скидкой 20%
Академия Информационных Систем запустила карьерные треки — курсы сразу объединены под конкретные профессиональные роли.
📖 Сейчас доступны направления:
— разработка на Python;
— DevOps и контейнеры;
— BI и аналитика;
— PostgreSQL и базы данных.
В каждом направлении можно выбрать уровень подготовки: начальный, продвинутый или комплексный. Например, для Python доступны треки от подготовки Python-разработчика данных до продвинутого Python-разработчика с ИИ; в направлении DevOps — обучение работе с Kubernetes и контейнерными платформами, а также трек для DevOps-инженеров инфраструктуры.
При покупке карьерного трека действует скидка до 20%.
Выберите направление и готовый маршрут обучения под профессиональные задачи 🌟