Не попадитесь на накрученные каналы! Узнайте, не накручивает ли канал просмотры или
подписчиков
Проверить канал на накрутку


Телеграм канал «Crypto Monkeys»
Crypto Monkeys
8.1K
22.1K
510
241
26.0K
Cообщество крипто хаслеров.
Новости, ретродропы, ICO, авторские статьи и подкаcты.
Chat: telemetr.me/+MifW_zynHrIzMDhi
Youtube: https://www.youtube.com/@cryptomonkeys888
Все ресурсы: telemetr.me/cryptomonkeyzz/7
🤝 Партнерство и реклама: @museDead
Новости, ретродропы, ICO, авторские статьи и подкаcты.
Chat: telemetr.me/+MifW_zynHrIzMDhi
Youtube: https://www.youtube.com/@cryptomonkeys888
Все ресурсы: telemetr.me/cryptomonkeyzz/7
🤝 Партнерство и реклама: @museDead
Подписчики
Всего
5 873
Сегодня
0
Просмотров на пост
Всего
264
ER
Общий
4.49%
Суточный
3.98%
Динамика публикаций

Telemetr - сервис глубокой аналитики
телеграм-каналов
телеграм-каналов

Получите подробную информацию о каждом канале
Отберите самые эффективные каналы для
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам

Анализируйте рекламные посты
и креативы
и креативы
Узнайте какие посты лучше сработали,
а какие хуже, даже если их давно удалили
а какие хуже, даже если их давно удалили

Оценивайте эффективность тематики и контента
Узнайте, какую тематику лучше не рекламировать
на канале, а какая зайдет на ура
на канале, а какая зайдет на ура

Показано 7 из 8 096 постов
Смотреть все посты
Пост от 11.10.2026 19:16
62
3
3
Сейчас собираем дорожную карту проекта monty.fast
Напишите в комментариях, какие функции и улучшения вам было бы интересно увидеть у нас???
Учтём ваши идеи при планировании дальнейшего развития проекта
За лучшую идею подарим бонус 🎁
Или укажем автора идеи в дорожной карте)))
🐵 ВСЕ ССЫЛКИ MONKEYS
🐳 СТАНЬ MONKEYS ЭЛИТОЙ
💰Обменочка | Крипто СБП
MONTY - От идеи до опубликованного видео за 4 мин
🔥
1
Пост от 11.10.2026 16:44
83
1
3
Когда забыл наушники, и крипта в боковике
🐵 ВСЕ ССЫЛКИ MONKEYS
🐳 СТАНЬ MONKEYS ЭЛИТОЙ
💰Обменочка | Крипто СБП
MONTY - От идеи до опубликованного видео за 4 мин
🐵 ВСЕ ССЫЛКИ MONKEYS
🐳 СТАНЬ MONKEYS ЭЛИТОЙ
💰Обменочка | Крипто СБП
MONTY - От идеи до опубликованного видео за 4 мин
Пост от 11.10.2026 16:41
104
1
1
Память AI не просто большой контекст
Многие думают:
Если у модели огромное контекстное окно, значит она всё помнит
Нет
Представьте человека
Вы разговаривали с человеком 8 часов
Он может сохранить весь разговор, но когда вы задаёте ему новый вопрос, ему не нужно заново перечитывать все 8 часов. Он использует только то, что считает нужным
С агентами примерно так же
Есть долговременная история и активный контекст
Первая хранит историю работы, второй содержит информацию, которую модель получает при конкретном вызове
Как это работает на практике?
Допустим, в проекте 1000 файлов
Агенту не нужно читать их все при каждом запросе. Вместо этого он может:
Изучить структуру проекта
Найти нужный файл
Открыть конкретный фрагмент
Изучить его
При необходимости найти дополнительные сведения
Это называется постепенным раскрытием информации
Сначала агент получает необходимый минимум, а подробности подгружает по мере необходимости
А что происходит с длинными разговорами?
Когда история становится слишком большой, система может сжать её, заменив подробности кратким пересказом
Например, сначала ты подробно объяснил агенту задачу, уточнил несколько требований и отдельно попросил не менять определённую функцию
После сжатия осталось:
Пользователь работает над проектом и хочет исправить ошибку
Вроде всё верно, но важное уточнение про функцию потерялось
И вот здесь появляется проблема
Сначала эта деталь могла казаться неважной, но через несколько часов именно она может оказаться критичной
Если исходная история сохранилась, система может найти нужный фрагмент и вернуть его в контекст. Если информация нигде не сохранилась, восстановить её уже не получится
Поэтому хорошая система должна не просто сжимать историю, а уметь находить в ней нужные сведения и возвращать их в контекст, когда они снова становятся важными
Хорошая память AI это не просто хранение информации, а способность системы найти нужную деталь именно тогда, когда она понадобится
🐵 ВСЕ ССЫЛКИ MONKEYS
🐳 СТАНЬ MONKEYS ЭЛИТОЙ
💰Обменочка | Крипто СБП
MONTY - От идеи до опубликованного видео за 4 мин
Изображение
Пост от 10.10.2026 21:45
149
0
5
Лудка плечи от х100 до х1000
Торговать можно ETH и BTC
Как он работает?
По сути, это не привычные перпы с ордербуком, а синтетические свопы. Ты открываешь позицию не против другого трейдера, а против ликвидности самого протокола.
И интересный момент: пул LP начинается с нуля, а его капитал растёт за счёт проигрышей трейдеров.
Про токен PAPER
На старте у PAPER нулевой сапплай. Новые токены минтятся, когда трейдер закрывает сделку в минус или получает ликвидацию.
При этом изначально PAPER нельзя продать или перевести, но можно стейкать и фармить долю от доходов протокола в USDC
Максимально честный fair launch: никакого премайнта, аллокаций для команды, VC, аирдропов и вестинга. Даже реферальной программы и специальных условий для инфлюенсеров
https://exchange.papertrade.xyz/
Тут чем больше сумма тем больше приоритет твоего ордера , подвисает аккуратно
UPD дополнил пост
🐵 ВСЕ ССЫЛКИ MONKEYS
🐳 СТАНЬ MONKEYS ЭЛИТОЙ
💰Обменочка | Крипто СБП
MONTY - От идеи до опубликованного видео за 4 мин
Пост от 10.10.2026 20:46
1
0
0
Память AI не просто «большой контекст»
Многие думают:
Если у модели огромное контекстное окно, значит, она всё помнит
Нет
Представьте человека
Вы разговаривали с человеком 8 часов.
Он может сохранить запись всего разговора. Но когда вы задаёте ему новый вопрос, ему не обязательно заново перечитывать все 8 часов. Он использует то, что считает нужным для ответа.
С агентами похожая история.
Здесь важно различать два слоя:
Долговременная история — сохранённые сообщения, события и состояние работы.
Активный контекст — информация, которую передают модели при конкретном вызове.
Это не одно и то же.
Как это работает на практике?
Допустим, в проекте 1000 файлов.
Агенту не нужно загружать все 1000 файлов при каждом запросе. Вместо этого он может:
Изучить структуру проекта.
Найти нужный файл.
Открыть конкретный фрагмент.
Изучить его и выполнить задачу.
При необходимости найти дополнительные сведения.
Это называется постепенным раскрытием информации (progressive disclosure).
Сначала агент получает необходимый минимум, а подробности подгружает по мере необходимости.
Большое контекстное окно не превращает всю доступную информацию в одинаково полезную.
А что происходит с длинными разговорами?
Когда история становится слишком большой, система может сжать её, заменив подробности кратким пересказом.
Например, было:
Пользователь сначала предложил вариант X, затем изменил требования на Y, отдельно уточнил Z и ещё 50 деталей.
После сжатия осталось:
Пользователь работает над проектом X и хочет получить результат Y.
Выглядит нормально. Но часть деталей могла потеряться.
В справочнике «Инженерия обвязки агентов» это выражено простой формулой:
C(H) ≠ H
То есть сжатая история не равна оригинальной.
И здесь важный нюанс: сжатие контекста не обязательно означает удаление исходной истории. Она может храниться отдельно, за пределами активного контекста.
И вот здесь появляется главная проблема
Сегодня какая-нибудь деталь казалась ненужной.
А через три часа она внезапно стала критичной.
Если деталь потерялась при сжатии, в кратком пересказе её уже нет. Но если исходная история сохранена, система потенциально может найти её снова.
Для этого недостаточно просто хранить историю. Нужно уметь искать в ней нужные сведения и возвращать их в активный контекст, когда они понадобятся.
Поэтому хорошая система должна не просто сжимать память, а грамотно управлять ею:
сохранять важное состояние;
не перегружать модель лишней информацией;
находить старые детали по мере необходимости;
проверять, не потерялось ли что-то критичное при сжатии.
В конечном счёте память агента — это не только то, что он сохранил. Это ещё и то, что он способен восстановить в нужный момент.
Пост от 10.10.2026 20:20
162
4
4
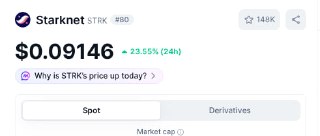
STRK сделал пук
Starknet (сракнет) официально объявил, что активно рассматривает переход с Ethereum L2 на независимый Layer 1, чтобы стать первой полностью квантово-устойчивой сетью к 2027 году)))
Источник: https://x.com/starknet/status/2108113391525204034
Дно 0,02225 4х от дна как будто вкусно?
АТХ 3,66 или минус 97,35%, уже не вкусно))🤣🤣🤣
🐵 ВСЕ ССЫЛКИ MONKEYS
🐳 СТАНЬ MONKEYS ЭЛИТОЙ
💰Обменочка | Крипто СБП
MONTY - От идеи до опубликованного видео за 4 мин
😁
5
Пост от 10.10.2026 20:15
19
0
1
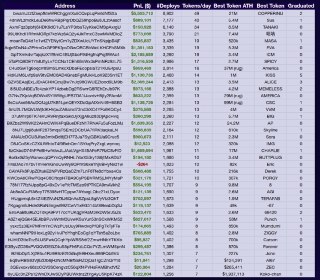
Топ-250 деплойеров на Pumpfun
Статистика
🔜 извлекли $79+ КК из траншей
🔜 запустили 194+K токенов (1100 в день) за последние 6 месяцев
🔜создали всего 10+ токенов с капитализацией 5M+»
🐵 ВСЕ ССЫЛКИ MONKEYS
🐳 СТАНЬ MONKEYS ЭЛИТОЙ
💰Обменочка | Крипто СБП
MONTY - От идеи до опубликованного видео за 4 мин
Статистика
🔜 извлекли $79+ КК из траншей
🔜 запустили 194+K токенов (1100 в день) за последние 6 месяцев
🔜создали всего 10+ токенов с капитализацией 5M+»
🐵 ВСЕ ССЫЛКИ MONKEYS
🐳 СТАНЬ MONKEYS ЭЛИТОЙ
💰Обменочка | Крипто СБП
MONTY - От идеи до опубликованного видео за 4 мин