Не попадитесь на накрученные каналы! Узнайте, не накручивает ли канал просмотры или
подписчиков
Проверить канал на накрутку


Телеграм канал «Код Желтый»
Код Желтый
2.1K
2.3K
455
102
15.2K
Рассказываем про технологии и инженерные практики. Делимся подкастами, анонсами ИТ-мероприятий и исследованиями.
ВК: vk.com/kod_zheltyi
Команда и вакансии в Т: telemetr.me/t_crew
ИТ-профессии в Т: l.tbank.ru/it_folders
Перечень РКН: l.tbank.ru/knd_tg
ВК: vk.com/kod_zheltyi
Команда и вакансии в Т: telemetr.me/t_crew
ИТ-профессии в Т: l.tbank.ru/it_folders
Перечень РКН: l.tbank.ru/knd_tg
Подписчики
Всего
33 553
Сегодня
0
Просмотров на пост
Всего
3 054
ER
Общий
9.1%
Суточный
6.8%
Динамика публикаций

Telemetr - сервис глубокой аналитики
телеграм-каналов
телеграм-каналов

Получите подробную информацию о каждом канале
Отберите самые эффективные каналы для
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам

Анализируйте рекламные посты
и креативы
и креативы
Узнайте какие посты лучше сработали,
а какие хуже, даже если их давно удалили
а какие хуже, даже если их давно удалили

Оценивайте эффективность тематики и контента
Узнайте, какую тематику лучше не рекламировать
на канале, а какая зайдет на ура
на канале, а какая зайдет на ура

Показано 7 из 2 071 поста
Смотреть все посты
Пост от 21.10.2026 13:04
782
0
5
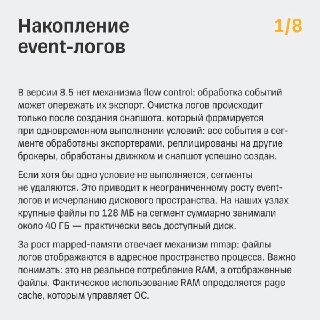
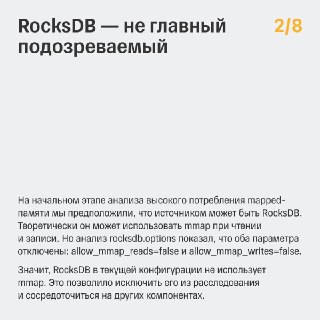
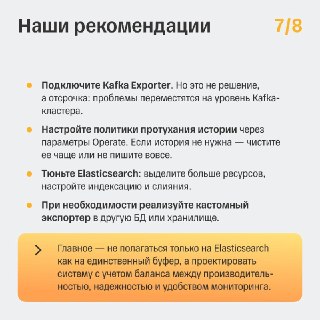
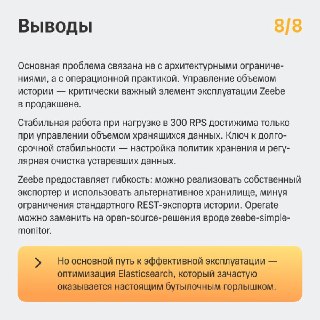
🔥 Что происходит с Zeebe при долгой эксплуатации
В прошлый раз мы разобрали архитектуру Zeebe, отказоустойчивость и асинхронную обработку. Но за высокой производительностью в начале эксплуатации может скрываться постепенное замедление.
Мы столкнулись с этим на практике: диск заполнялся event-логами, Elasticsearch переставал справляться, а история в Operate отставала на часы. В карточках разбираем, почему это происходит и что с этим делать. А подробнее читайте на Хабре.
#zeebe #camunda #elasticsearch #performance #workflow
❤
3
👍
1
Пост от 21.10.2026 13:04
755
0
2
❤
4
🔥
3
❤🔥
2
Пост от 19.10.2026 15:11
329
0
2
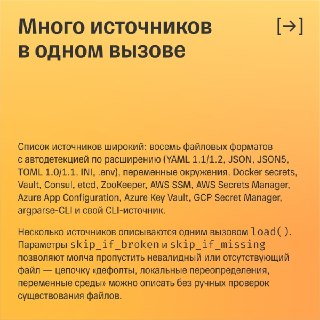
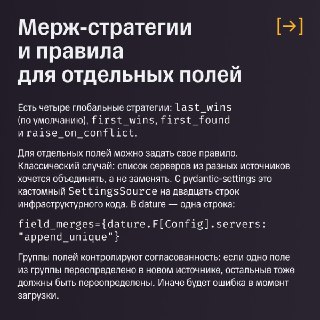
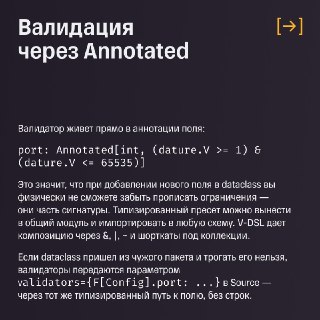
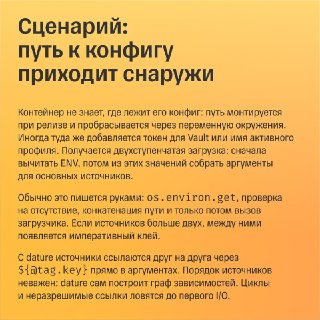
*️⃣ Библиотека конфигурации, которая не теряет источники значений
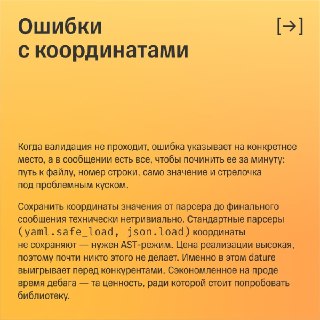
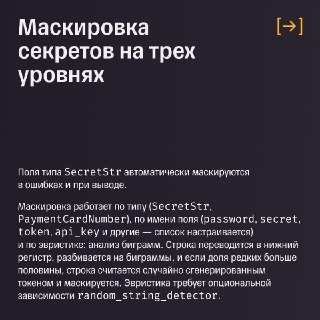
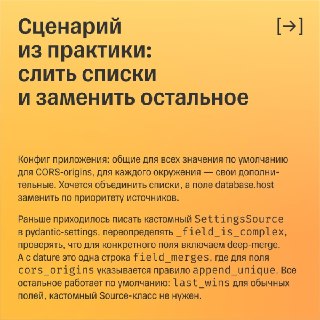
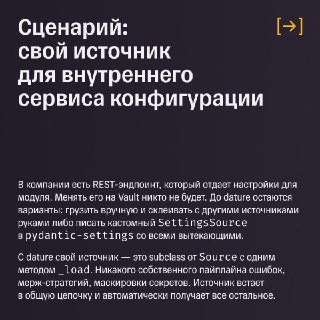
В прошлых постах мы разобрали, как индустрия пришла к современным подходам конфигурации, и проверили четыре популярные библиотеки по семи требованиям. Ни одна из них не закрыла все пункты, поэтому мы решили создать свою.
Она загружает данные из произвольных источников в обычный dataclass из стандартной библиотеки, не захватывает точку входа и не навязывает свою экосистему. В карточках создатель библиотеки Николай Видов поделился, как она устроена, какие источники поддерживает и где помогает на практике. Больше деталей и сравнительная таблица с другими библиотеками — на Хабре.
↗️ Попробовать dature в деле
#python #configuration #devtools #opensource #dataclass
👍
2
❤
1
🔥
1
Пост от 16.10.2026 14:41
938
1
15
⚡️ Если вы тоже собираете такие пазлы вручную, чтобы подготовиться к ревью или просто начать рабочий день — читайте, как мы справились с этой задачей
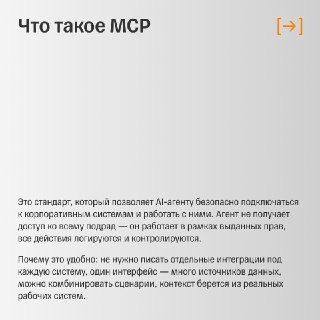
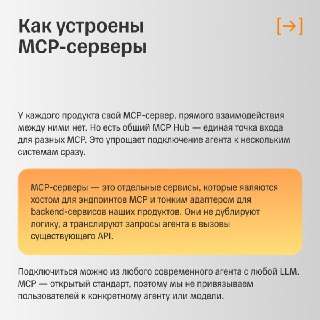
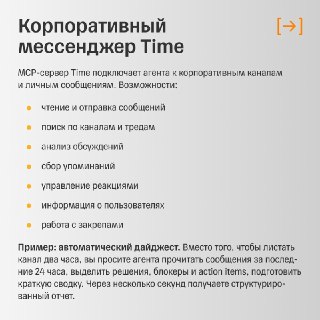
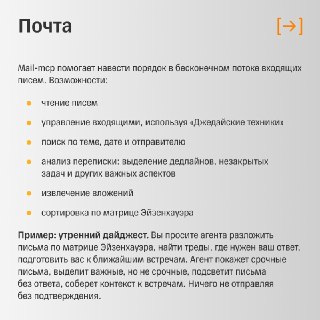
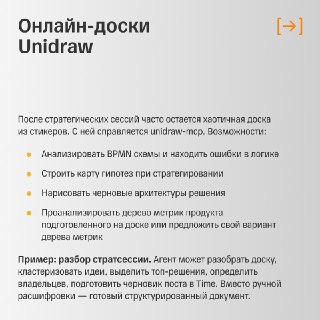
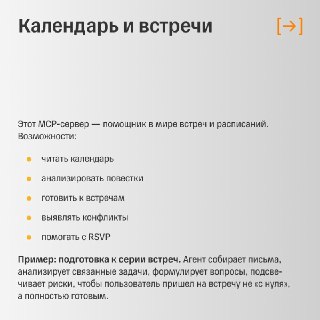
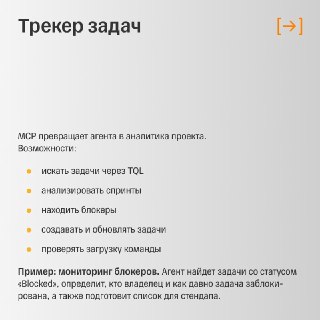
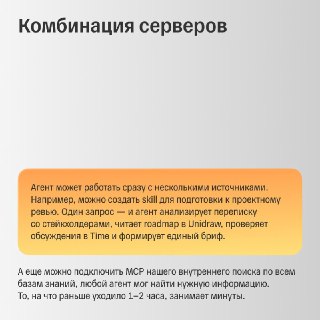
Наша команда Office Productivity внедрила MCP-стандарт, позволяющий AI‑агентам безопасно собирать контекст из мессенджера Time, почты, онлайн-досок Unidraw, трекера задач, внутреннего поиска и календаря. Вместо переключения между вкладками пользователь формулирует задачу один раз — и агент сам собирает контекст из разных систем, анализирует его и готовит результат.
В карточках рассказываем, как устроен MCP и какие сценарии уже используют коллеги.
#mcp #ai #productivity #devtools #agents
❤
8
👍
5
Пост от 16.10.2026 14:30
429
1
2
☕️ Представьте: вам нужно подготовиться к проектному ревью, а артефакты раскиданы по десяткам систем
Собирайте свой пазл, куда пойдете в первую очередь — в переписки с коллегами, почту, таск-трекер, доки, комментарии в IDE или онлайн-доски.
Как это сделать?
↗️ Сохраните картинку из поста.
↗️ Добавьте к себе стикерпак.
↗️ Перейдите в комментарии, прикрепите сохраненную картинку и откройте разлел редактирования.
↗️ Добавьте нужные стикеры и отправьте картинку.
❤
3
👍
1
Пост от 15.10.2026 11:10
799
0
22
👍
6
❤
4
👎
1
Пост от 14.10.2026 13:36
2 048
1
39
⚡️ Как ускорить A/B-тест с несколькими метриками, не ломая статистику
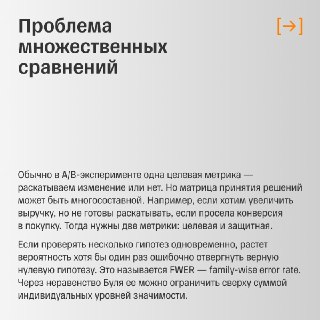
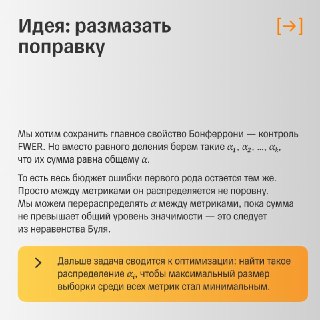
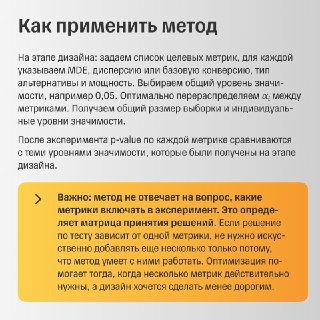
В продуктовых экспериментах часто одна целевая метрика. Но бывает сложнее: например, хотим увеличить выручку, но не готовы раскатывать, если просела конверсия в покупку. Значит, метрик будет несколько, и нужно контролировать вероятность хотя бы одной ложноположительной ошибки.
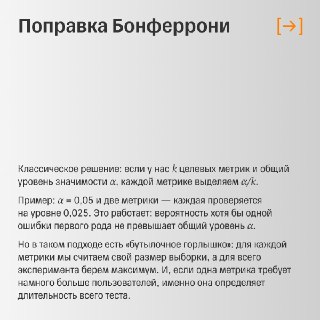
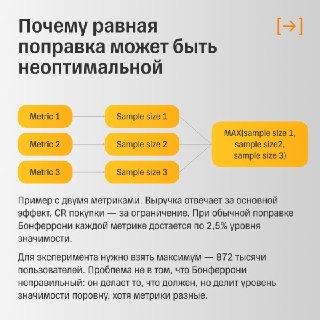
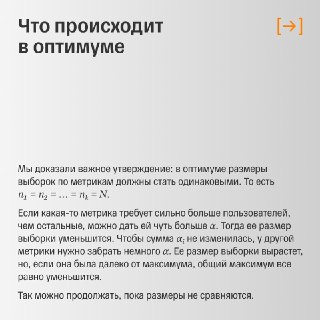
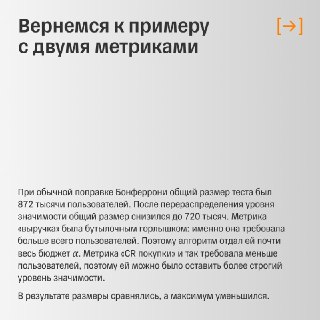
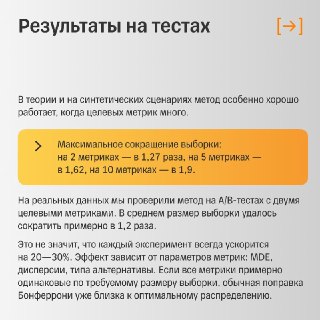
Классическое решение в таком случае — поправка Бонферрони. Делим общий уровень значимости поровну между метриками. Это просто, но не всегда эффективно: если одна метрика требует сильно больше пользователей, именно она определяет длительность всего теста.
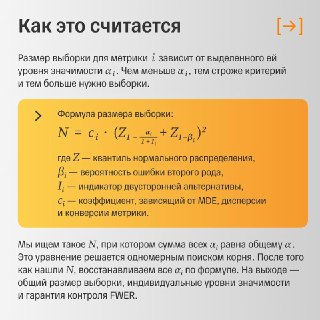
В нашей лаборатории прикладной статистики предложили не делить уровень значимости поровну, а распределять его оптимально. Контроль ошибки первого рода сохраняется, а размер выборки в наших тестах сократился в среднем в 1,2 раза. На синтетике с 10 метриками выигрыш доходит до 1,9 раза.
В карточках — о том, как устроен метод и где он дает эффект. А подробности, математика и результаты экспериментов — на Хабре.
#abtesting #statistics #experiments #productanalytics
🔥
17
👍
10
❤🔥
6
❤
2
👎
1