Не попадитесь на накрученные каналы! Узнайте, не накручивает ли канал просмотры или
подписчиков
Проверить канал на накрутку


Телеграм канал «QA-Логия»
QA-Логия
5.3K
2.6K
670
0
14.7K
Все о QA. Канал для тестировщиков
Личный блог автора - @just_genych
По вопросам рекламы или разработки: @g_abashkin
Личный блог автора - @just_genych
По вопросам рекламы или разработки: @g_abashkin
Подписчики
Всего
7 821
Сегодня
-3
Просмотров на пост
Всего
165
ER
Общий
2.1%
Суточный
1.64%
Динамика публикаций

Telemetr - сервис глубокой аналитики
телеграм-каналов
телеграм-каналов

Получите подробную информацию о каждом канале
Отберите самые эффективные каналы для
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам

Анализируйте рекламные посты
и креативы
и креативы
Узнайте какие посты лучше сработали,
а какие хуже, даже если их давно удалили
а какие хуже, даже если их давно удалили

Оценивайте эффективность тематики и контента
Узнайте, какую тематику лучше не рекламировать
на канале, а какая зайдет на ура
на канале, а какая зайдет на ура

Показано 7 из 5 320 постов
Смотреть все посты
Пост от 19.10.2026 12:07
33
0
5
Fetch для QA: тестим API прямо в DevTools без Postman
Был у автора этап тестов, когда понадобилось накидать 50+ одинаковых сущностей, отличались только названия. По-нормальному это делают руками через интерфейс: открой форму, забей поля, сохрани — и так полсотни раз. Одна штука съедает где-то 20 секунд, в сумме набегает больше 15 минут тупых однотипных действий.
Но он вспомнил про fetch — функцию в DevTools на вкладке Console. Пара минут на скрипт, и те же 50 сущностей готовы за минуту: экономия опять же больше 15 минут. В статье разбирают, как это устроено, дают шаблон запроса, показывают, как копировать его из DevTools и гонять запросы пачками и параллельно, не вылезая из браузера.
Читать далее
QA-логия
Пост от 18.10.2026 18:07
34
0
1
👩💻 Всем программистам посвящается!
Вот 14 авторских обучающих IT каналов по самым востребованным областям программирования:
Выбирай своё направление:
👩💻 Python — telemetr.me/python_ready
🤔 InfoSec & Хакинг — telemetr.me/hacking_ready
🖥 SQL & Базы Данных — telemetr.me/sql_ready
👩💻 IT Новости — telemetr.me/it_ready
🤖 AI & ML — telemetr.me/neuro_ready
👩💻 Frontend — telemetr.me/frontend_ready
👩💻 C/C++ — telemetr.me/cpp_ready
👩💻 C# & Unity — telemetr.me/csharp_ready
👩💻 Linux — telemetr.me/linux_ready
👩💻 Java — telemetr.me/java_ready
📖 IT Книги — telemetr.me/books_ready
📱 JavaScript — telemetr.me/javascript_ready
🖼️ DevOps — telemetr.me/devops_ready
🖥 Design — telemetr.me/design_ready
📌 Гайды, шпаргалки, задачи, ресурсы и фишки для каждого языка программирования!
Пост от 18.10.2026 12:07
26
0
1
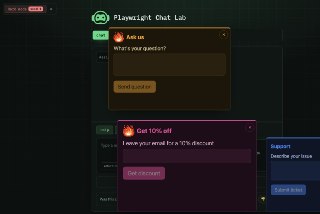
Flaky по заказу: полигон для прокачки стабильных e2e-тестов на Playwright
Зелёный прогон на учебной песочнице ровным счётом ничего не гарантирует — на живом проекте этот же тест легко упадёт через раз. Автор рассказывает про тренажёр: поначалу всё как обычный курс, а потом включается Hard Mode — бесячие попапы, тормозящий бэкенд и промо, которое накрывает экран аккурат в самый неудобный момент.
Что по содержимому: 11 уроков, Hard Mode с воспроизводимыми флаками и Flake Score — метрика, которая покажет, переживёт ли твой тест реальный проект. Читать далее
👉 QA-логия
Пост от 16.10.2026 12:07
31
0
3
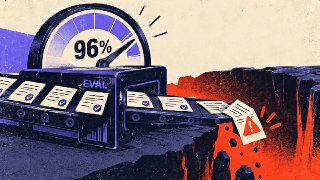
Тестирование LLM‑фичи: а своему eval точно можно верить?
Eval рисует 96% качества, прогон зелёный — а после выката LLM‑ассистент косячит по-крупному. И корень, возможно, в самой системе оценки: она не отлавливает опасные ответы и дарит ложное чувство, что всё под контролем.
Дальше — семь косяков в тестировании LLM‑функций и то, как собрать eval, которому реально можно доверять. Проверить свой eval
👉 QA-логия
Пост от 16.10.2026 10:07
26
0
1
⚡️ В сети начали массово сливать IT-курсы и книги известных онлайн школ
Вот отсортированная база с тонной материала (постепенно пополняется):
(363 видео, 87 книги) — Python
(117 видео, 53 книги) — ВАЙБКОД
(174 видео, 91 книги) — DevOps
(415 видео, 68 книги) — Frontend
(137 видео, 93 книги) — DS/ML
(143 видео, 33 книги) — ИБ/Хакинг
(352 видео, 89 книги) — С/С++/C
(343 видео, 87 книги) — Java/QA
(176 видео, 32 книги) — Git/Linux
(167 видео, 53 книги) — PHP/1С
(227 видео, 83 книги) — SQL/БД
(114 видео, 77 книги) — Сисадмин
(107 видео, 43 книги) — BA/SA
(181 видео, 32 книги) — Go/Rust
(167 видео, 43 книги) — Kotlin/Swift
(112 видео, 24 книги) — Flutter
(113 видео, 82 книги) — GameDev
(183 видео, 37 книги) — Дизайн
(136 видео, 33 книги) — PM/HR
Скачивать ничего не нужно — все выложили в Telegram
Пост от 15.10.2026 12:07
32
0
2
Первый RAG комом: как в hh.ru учат LLM анализировать ошибки автотестов
Алексей — автотестер в hh.ru. В конторе у него порядка трёх тысяч классов с e2e (UI) тестами на Java. Гоняют их по несколько раз в сутки, и именно они — главный quality gate. Только вот тесты нет-нет да и флакнут. А с этим надо что-то делать.
Против нестабильности давно работает автокарантин: как только тест поплыл, крон выкидывает его из прогонов и заводит в Jira тикет на владельца — мол, разбирайся. Как всё это устроено, в hh.ru на Хабре уже писали. А теперь туда прикрутили LLM: тест уезжает в карантин, нейросеть смотрит на ошибку и подкидывает владельцу пачку гипотез о том, почему оно упало, плюс варианты починки — если косяк на стороне самих тестов.
В статье автор рассказывает, как задачу пилили, почему классический RAG с векторным поиском не вывез и как в итоге дошли до схемы, где LLM сама решает, какой код ей нужен для разбора. Читать далее
👉 QA-логия
Пост от 14.10.2026 10:09
40
0
1
АЙТИШНИКИ БЕСПЛАТНОЕ ОБУЧЕНИЕ
Проект «Terminal» стал крупнейшей библиотекой бесплатного образования. В одном канале собраны курсы, книги, полезные инструменты и практические тренажёры для всех разработчиков:
• Практические курсы и задания
• Книги и статьи известных авторов
• Полезные инструменты и ресурсы
• IT-новости и инсайды
Обучение по всем направлениям: SQL, Python, ML, Frontend, PHP, C++, Go, Git, Linux, QA, Java, Vibe-coding, InfoSec и др.
⌨️ подписаться