Не попадитесь на накрученные каналы! Узнайте, не накручивает ли канал просмотры или
подписчиков
Проверить канал на накрутку


Телеграм канал «Выше квартилей»
Выше квартилей
594
203
318
267
4.6K
HSE: Home of Scientometrics and Expertise
Обучение и консультирование по практическим вопросам research evaluation и управлении наукой.
Все вопросы и предложения направляйте @vyshekbot или на почту Наукометрического центра ВШЭ: scientometrics@hse.ru
Обучение и консультирование по практическим вопросам research evaluation и управлении наукой.
Все вопросы и предложения направляйте @vyshekbot или на почту Наукометрического центра ВШЭ: scientometrics@hse.ru
Подписчики
Всего
3 350
Сегодня
-3
Просмотров на пост
Всего
487
ER
Общий
14.51%
Суточный
12.51%
Динамика публикаций

Telemetr - сервис глубокой аналитики
телеграм-каналов
телеграм-каналов

Получите подробную информацию о каждом канале
Отберите самые эффективные каналы для
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам

Анализируйте рекламные посты
и креативы
и креативы
Узнайте какие посты лучше сработали,
а какие хуже, даже если их давно удалили
а какие хуже, даже если их давно удалили

Оценивайте эффективность тематики и контента
Узнайте, какую тематику лучше не рекламировать
на канале, а какая зайдет на ура
на канале, а какая зайдет на ура

Показано 4 из 594 постов
Смотреть все посты
Пост от 01.10.2026 17:00
92
0
0
Дайджест сентябрь 2026:
Представляем дайджест научных событий за прошедший месяц.
Наукометрия и рейтинги
• Недавняя работа в Scientometrics показывает, что месяц публикации влияет на FWCI при прочих равных: от февраля к ноябрю медианный показатель становится ниже примерно на 39 %. Очередная демонстрация того, почему даже нормализованные метрики не всегда могут служить опорой для сравнения исследований.
• Ранее мы уже писали о том, что Китайская академия наук прекратила публикацию своего журнального рейтинга. Теперь же выяснилось, что университеты отреагировали на новость по-разному: где-то сохранился учет CAS в последней редакции, где-то ему на смену пришел Xinrui, а в отдельных случаях учитываются теперь оба списка. Хороший кейс для демонстрации того, как именно университетские правила игры адаптируются к меняющимся условиям.
• Crossref улучшает видимость данных: новый алгоритм научился точнее связывать научные статьи с организациями, которые их финансировали. Если в статье нет идентификатора организации, Crossref определяет её по названию через реестр ROR. Точность такого сопоставления по словам команды Crossref составляет 99 %.
• В OpenAlex задумались о внедрении показателя научной новизны. Кандидатом на метрику стала AI-derived novelty score от команды Forschungszentrum Jülich, победившей в конкурсе Metascience Novelty Indicators Challenge 2026 года. Модель сравнивает исследование с цитируемыми работами, восстанавливает состояние знаний на момент публикации и оценивает, что нового добавляет статья.
• Еще одна потенциальная маленькая революция от OpenAlex на стадии обсуждения: предложение отказаться от цветовой схемы открытого доступа. По мнению команды, текущая версия уже слабо соответствует тому многообразию открытых доступов, что сложились за последние годы. Если планируете присоединиться к дискуссии — самое время это сделать, сбор отзывов продлится до 13 ноября.
• Clarivate по традиции представили список потенциальных лауреатов Нобелевской премии, основываясь на показателях цитирования. Кстати, сама Нобелевская неделя стартует уже 5 октября, также традиционно планируем посвятить ей несколько постов.
ИИ в науке
• В Web of Science появятся полные тексты статей и ИИ-инструменты для анализа их содержания. Благодаря DeepR больше не придётся переходить на сайты издательств за PDF-файлами — пользователи сразу получат доступ к полному тексту и ИИ-сводку с краткой выжимкой материала.
• О научных статьях, превращённых в ИИ-агентов, способных не только работать с их содержанием, но и выполнять связанные с ними исследовательские задачи, рассказали в Nature. Благодаря системе Paper2Agent статья и её код анализируются, после чего создаётся специальный сервер, превращающий исследование в ИИ-агента. С ним можно общаться, просить выполнить анализ или воспроизвести методы из статьи.
Редакционная политика и научная этика
• Более 120 представителей научного сообщества из разных стран поддержали забастовку сотрудников медицинского журнала The Lancet. Первая более чем за 200 лет забастовка стала ответом на новое предложение Elsevier по зарплате. На голосовании 94,5% участников поддержали забастовку, которая началась 22 сентября.
• Из наиболее интересных сюжетов Retraction Watch — заметка на основе недавнего препринта о том, что статьи "бумажных фабрик" (paper mills) успевают попасть в патенты, стратегические документы (policy documents) и клинические рекомендации и продолжают там жить после ретракций.
Наука в России
• В России ИИ поддерживают заметно чаще, чем регулируют. По опросу ИСИЭЗ НИУ ВШЭ, меры поддержки есть у 65 % организаций, а формальные внутренние документы — у 14 %. Применение нейросетей опережает политику по формальному закреплению их применения.
#дайджест #наукометрия #рейтинги #иивнауке #редакционнаяполитика #научнаяэтика #наукавроссии
👍
2
Пост от 29.09.2026 12:34
137
0
9
⏳ Сколько живут научные идеи?
12 октября объявят лауреатов Нобелевской премии по экономике (можете попробовать их угадать вместе со СМУч ЭФ), но сегодня мы решили поговорить не о лауреатах, а об идеях
Как измерить скорость научного прогресса? Считать статьи бессмысленно: их выходит около 15 млн в год, и по этой мерке мы живём в золотой век. Считать деньги тоже так себе идея: каждое следующее открытие обходится дороже, и растущие расходы лишь удерживают прежний темп
Эндрю Уайт предлагает мерить иначе – временем жизни научного утверждения (claim): сколько оно держится, прежде чем его пересмотрят или опровергнут (White, 2026). По сути это взгляд на прогресс по Томасу Куну: наука движется не объёмом написанного, а тем, как часто приходится переписывать уже написанное
⏮ Как это посчитано?
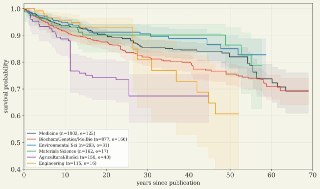
Утверждения здесь рассматривают как пациентов в клиническом исследовании. Берётся 151 обзорная статья по химии, медицине, биологии, материаловедению и другим областям, с 1950-х по 2010-е. Из них языковой моделью извлечены 3 444 утверждения, и момент попадания в обзор считается «рождением». Дальше поисковый агент PaperQA3 ищет, не пересмотрено ли утверждение: чтобы признать его изменённым или опровергнутым, нужен DOI опровергающей работы. Сдвиги меньше 20% от заявленной величины засчитываются как «выжило», пересмотр считается «смертью». Далее автор строит кривые Каплана-Мейера
Выглядит это так. В обзоре 1966 года сказано, что пятая жаберная дуга аорты исчезает после пятой недели развития и не оставляет никаких структур. Современные работы по эмбрионам мыши и человека показали, что такая артерия вообще не формируется, а то, что за неё принимали, – коллатерали и аномалии. Утверждение прожило полвека и умерло
⏮ Что получилось?
• Период полураспада научного утверждения – 115 лет: столько нужно, чтобы пересмотру подверглась половина. Зато уже через десять лет пересмотренными оказываются около 10%
• Интереснее разбивка по десятилетиям: у утверждений 1950-х ожидаемый полураспад около 250 лет, у 2000-х – уже 70. Если разгон продолжится, к 2212 году полураспад сократится до года, а к 2494-му – до суток. Автор называет это сингулярностью: картина мира переписывается быстрее, чем человек успевает её прочесть
⏮ Где нужно быть осторожным?
Автор признаёт ограничения:
• экстраполяция уходит далеко за пределы данных: пересмотров всего 529 на 3 444 утверждения, а у недавних десятилетий их мало просто потому, что прошло слишком мало времени. Само предположение об экспоненциальном ускорении ничем не проверено
• выборка смещена дважды: в обзоры попадают только утверждения, которые уже стали заметны, а открытый доступ перекошен в сторону последних десятилетий
• разметку делала языковая модель: эксперты соглашались с её оценками в 70% случаев, да и проверяли это на моделях двухлетней давности (Skarlinski et al., 2024)
• трудно решить, что считать утверждением: у слишком узких формулировок нет продолжения в литературе, и «выжило» не отличить от «никто не проверял»
От себя добавим, что это хоть и очень интересный, но пока всего лишь пост в блоге, а не рецензируемая статья. Но зато автор открыто поделился своими данными
⏮ Зачем это нам?
• Сюжет спорит с привычной картиной замедления науки: идеи становится всё труднее находить (Bloom et al., 2020) [см. пост], статьи и патенты теряют прорывность (Park et al., 2023), а разрыв между работой и Нобелевской премией растёт (Mitsis, 2022). Здесь же выходит, что оборот фактов ускоряется
• К разговорам о скором скачке наука привыкла давно: Генри Адамс делил историю на эпохи – механическая триста лет, электрическая двадцать – и ждал сингулярности к 1921 году. Он не так уж промахнулся: модель атома с 1904 по 1926 год сменилась примерно восемь раз, а каково было издателям учебников физики, можно только гадать
Хотя, если вдуматься, Уайт измерил не то, как быстро мы узнаём правду, а то, как быстро правим прежние записи. Тогда рост числа пересмотров может означать и ускорение науки, и просто удешевление проверки – теми же языковыми моделями, с помощью которых сделана эта работа
#канал_обозревает
@causal_channel
❤
2
Пост от 15.09.2026 16:00
328
0
15
Импакт vs. ИИмпакт: эмпирические свидетельства влияния LLM на цитирование публикаций
В последнее время мы часто пишем о том, как ИИ меняет привычный научный ландшафт: во все большем числе работ генеративный ИИ помогает не только дописывать отдельные абзацы, но и с подачи промптов берет на себя исследовательские функции. Между тем немалое количество ученых все еще рассматривает генеративный ИИ только в качестве помощника по редактуре текста, позволяющего "подогнать" публикацию под требования журнала или же стандарты академического языка (в особенности иностранного для самих авторов). Казалось бы, добросовестное и декларируемое применение ИИ в части работы с текстом статьи при прочих равных не должно давать дополнительных преимуществ исследователям в сравнении с их коллегами. Но так ли это?
В свежем исследовании, опубликованном в Scientometrics, наши коллеги из кампуса НИУ ВШЭ в Перми попытались ответить на этот вопрос, сфокусировавшись на взаимосвязи между использованием больших языковых моделей (LLM) при подготовке текста и показателями последующей цитируемости публикаций.
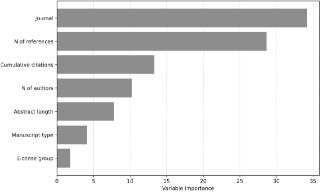
На основе анализа более 234 тыс. научных работ 2019–2025 годов при обращении к собственной модели идентификации паттернов ИИ-письма (LLM-assisted writing), авторы пришли к выводу, что публикации с такими признаками получали в среднем примерно на 7,04 % больше цитирований, чем работы с аналогичными характеристиками: опубликованные в тех же журналах, в рамках схожих по объему авторских коллективов, со схожим числом источников, длиной аннотации и предыдущей цитируемостью авторов. Значимость всех указанных характеристик для обученной модели приведена на графике.
Как отмечают сами авторы, применение ИИ может и не повышать качество самих научных исследований, но благодаря проработке аннотаций — улучшению структуры, удалению лишних слов, стандартизации формулировок и приведению текста к академическому стилю — улучшается видимость публикаций для читателей, что и способствует росту цитируемости. Внимание к аннотациям особенно важно, поскольку именно они попадают в поисковые системы, базы научного цитирования и могут использоваться самими LLM моделями и иными рекомендательными системами при подготовке списков литературы по теме.
В контексте же наукометрии исследование подчёркивает значимость ИИ-признаков как потенциального инструмента продвижения научных работ. Если ранее большее значение (хотя и не всегда) имело содержание статей, то теперь только особенности текста и использованных формулировок, могут при прочих равных влиять на повышение читательского интереса.
ИИ при этом прямо «не накручивает» цитаты, но ставит под сомнение один из основных столпов библиометрического анализа — индекс цитирования. Если даже относительно безобидная редактура текста систсематически связана с преимуществом в цитировании, то сама цитата сегодня — уже не только мера научной значимости работы, но и оценка ее "упаковки". По всей видимости, для исследователя, до сих пор сторонившегося ИИ-письма, рациональной стратегией все же становится использование LLM-инструментов при финальном редактировании текста публикации.
#обзор #ИИ #цитируемость #scientometrics
❤
2
🤔
2
👍
1
Пост от 09.09.2026 13:30
686
1
9
ИИ, CSRanking и БРИКС: взгляд "Выше квартилей"
Сегодня обсуждение достижений ИИ во многом строится вокруг отдельных ярких результатов продвинутых моделей. Чего только стоит свежая история решения задачи Навье–Стокса и дискуссия о первенстве в споре "машина vs. человек".
При этом развитие исследований в области ИИ можно рассматривать, безусловно, и через наукометрическую оптику. В последнем дайджесте мы обещали чаще возвращаться сюда с собственными аналитическими материалами. Одним из них хотим поделиться сегодня.
Что мы сделали?
Мы проанализировали 10 ведущих конференций в области искусственного интеллекта и машинного обучения. Все относятся к конференциям уровня A* в ICORE 2026 и при этом представляют разные направления компьютерных наук: от обработки естественного языка и компьютерного зрения до машинного обучения и анализа данных.
Напомним, что для области конференционные публикации имеют особое значение и являются одним из основных способов представления новых научных результатов. В качестве одного из ориентиров для проекта использовали подход CSRankings, но мы расширили для себя задачу: нас интересовали не только отдельные организации, но также их типы и структура сотрудничества между ними.
Что считали?
В основу анализа легли метаданные Scopus за 2020–2025 годы. В итоговый массив вошло более 104 тыс. публикаций (около 97,3 % материалов сборников). Отдельно выделили основные программы и дополнительные треки, рассчитали показатели публикационной активности, фракционного вклада, цитирования и FWCI, а также рассмотрели различные типы связей.
Часть процедур по сбору, проверке и обработке данных удалось автоматизировать с помощью ИИ. В этом смысле проект об исследованиях ИИ сам в определённой степени оказался продуктом совместной работы человека и ИИ.
Основной фокус мы решили сделать не на всех странах, а на классической пятерке БРИКС: Бразилии, России, Индии, Китае и ЮАР.
Каковы основные результаты?
Прежде всего, своим масштабом обращает на себя внимание Китай: более 38 тыс. публикаций, второе место в мире по объёму публикаций в рассматриваемом корпусе и с большим отрывом лидерство среди стран БРИКС как на уровне отдельных организаций, так и на уровне исследовательских команд. При сохранении текущей динамики выход Китая на 1 место в мире по отобранной десятке конференций – вопрос времени.
Интересна и структура цитирований. Более половины цитирующих аффилиаций для китайских публикаций также относятся к Китаю. Для сравнения: у России и Индии эта доля составляет около 6–8 %. Речь здесь не о самоцитированиях, а о высокой внутренней концентрации научной коммуникации.
Существенно различается и структура национальных исследовательских систем. Для Китая и России характерно более тесное взаимодействие академического и корпоративного секторов. В Индии, Бразилии и ЮАР заметно более выражена ведущая роль академических организаций.
Фокус на России
Российский кейс особенно показателен. Среди академических организаций НИУ ВШЭ лидирует по общему числу публикаций, Сколтех – по фракционному вкладу; важное место занимает и МФТИ. В корпоративном секторе основными участниками остаются Яндекс и Сбер, однако в последние годы заметным становится присутствие Т-Банка и МТС. Отдельно стоит отметить AIRI, который занимает особое место по масштабу публикационной активности и положению в сети сотрудничества.
При этом связь академии и индустрии проявляется не только в совместных публикациях. В данных заметна группа исследователей с одновременными академическими и корпоративными аффилиациями. Такие «люди-мосты» фактически соединяют два сектора и играют заметную роль в российской модели исследований в области ИИ.
Что дальше?
Пока рассматриваем нашу работу как первую версию проекта. В дальнейшем планируем расширять набор конференций и показателей и уточнять результаты по мере обновления данных.
Результаты проекта доступны на сайте Наукометрического центра по ссылке.
#аналитика #ИИрейтинг #БРИКС #ICORE

👍
9
🔥
8