Инструменты
Каталог TGAds
Мониторинг
Детальная статистика
Анализ аудитории
Бот аналитики
Полезная информация
Инструкция Telemetr
Документация к API
MCP для ИИ-ассистента
Чат Telemetr
Не попадитесь на накрученные каналы! Узнайте, не накручивает ли канал просмотры или
подписчиков
Проверить канал на накрутку


Телеграм канал «FPGA-Systems Events»
FPGA-Systems Events
3.6K
15.0K
132
94
17.9K
Журнал @fpgasystems_fsm
@fpgasystems_embd
@fpgasystems_verification
@fpgasystems_dsp
Чат @fpgasystems
Boosty https://boosty.to/fpgasystems
=
Flood @fpgasystems_flood
Mems @fpgasystems_memasici
=
Больше инфо в боте @fpgasystems_bot
—
Вождь @KeisN13
@fpgasystems_embd
@fpgasystems_verification
@fpgasystems_dsp
Чат @fpgasystems
Boosty https://boosty.to/fpgasystems
=
Flood @fpgasystems_flood
Mems @fpgasystems_memasici
=
Больше инфо в боте @fpgasystems_bot
—
Вождь @KeisN13
Подписчики
Всего
7 088
Сегодня
0
Просмотров на пост
Всего
1 566
ER
Общий
22.21%
Суточный
13.39%
Динамика публикаций

Telemetr - сервис глубокой аналитики
телеграм-каналов
телеграм-каналов

Получите подробную информацию о каждом канале
Отберите самые эффективные каналы для
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам

Анализируйте рекламные посты
и креативы
и креативы
Узнайте какие посты лучше сработали,
а какие хуже, даже если их давно удалили
а какие хуже, даже если их давно удалили

Оценивайте эффективность тематики и контента
Узнайте, какую тематику лучше не рекламировать
на канале, а какая зайдет на ура
на канале, а какая зайдет на ура

Показано 7 из 3 621 поста
Смотреть все посты
Пост от 19.09.2026 09:20
196
0
2
Кстати Lattice обьявили о новом семействе Mach-N2, новое семейство secure-control FPGA на платформе Nexus 2.
Подробнее https://www.latticesemi.com/en/About/Newsroom/PressReleases/2026/Lattice-Expands-Secure-Control-FPGA-Leadership-with-New-Lattice-Mach-N2-Family
Кроме того анонсирован Lattice Prompt, который по факту MCP, обещают тесную интеграцию с каждым шагом разработки и анализа отчетов:
https://www.latticesemi.com/en/Products/DesignSoftwareAndIP/FPGAandLDS/Lattice-Prompt
Юзергайд на почитать https://www.latticesemi.com/api/document/download?id=55351
Подробнее https://www.latticesemi.com/en/About/Newsroom/PressReleases/2026/Lattice-Expands-Secure-Control-FPGA-Leadership-with-New-Lattice-Mach-N2-Family
Кроме того анонсирован Lattice Prompt, который по факту MCP, обещают тесную интеграцию с каждым шагом разработки и анализа отчетов:
https://www.latticesemi.com/en/Products/DesignSoftwareAndIP/FPGAandLDS/Lattice-Prompt
Юзергайд на почитать https://www.latticesemi.com/api/document/download?id=55351
👍
1
Пост от 17.09.2026 20:55
254
0
5
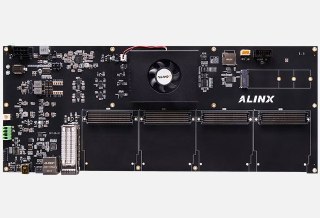
Больше FMC богам FMC: Alinx показали новую отладочную плату BZ11 с четырьмя FMC, в качестве мозгов по умолчанию SoM модуль с MPSoC XCZU11EG
К этому делу кстати Sundance опубликовали практический гайд посвященный видам FMC, полистать на вечер: https://www.sundancedsp.com/mixing-and-matching-fmc-and-fmc-boards-a-practical-guide/
К этому делу кстати Sundance опубликовали практический гайд посвященный видам FMC, полистать на вечер: https://www.sundancedsp.com/mixing-and-matching-fmc-and-fmc-boards-a-practical-guide/
🤔
3
Пост от 15.09.2026 07:45
545
0
3
Автор @ratragor с радостью примет критику и комментарии по статье: https://habr.com/p/1078296/
❤
1
Пост от 12.09.2026 21:46
264
0
5
Jane Street запустили новый ASIC Challenge - на этот раз предлагают спроектировать настоящий open-source чип, а лучшие проекты обещают затейпаутить за свой счёт.
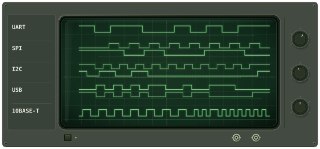
Задача довольно интересная: сделать general-purpose protocol emulator ASIC.
Идея в том, чтобы вместо отдельных UART, SPI и I2C контроллеров сделать универсальный программируемый контроллер, способный через GPIO реализовывать разные, в том числе кастомные, протоколы уже после изготовления чипа.
Первое, что тут приходит в голову, - PIO из Raspberry Pi RP2040. Собственно, сами Jane Street тоже приводят его в качестве одного из источников вдохновения.
https://rp2040pio-docs.readthedocs.io/en/latest/pio-programs.html
И тут, мне кажется, самое важное понять, где заканчивается FSM и начинается микроконтроллер 😁
Пару слов о формате. Когда задачка выходит за рамки одного дня, как мне кажется, она превращается из интересной головоломки в полноценный сайд-проект. Наверное, единственное, что подкупает в этом челлендже - Jane Street обещают затейпаутить самые интересные решения и отправить готовые чипы разработчикам. Честная это компенсация за такой объём работы или нет - решайте сами.
Если решили поучаствовать, в комментариях к посту можно найти единомышленников и организовать самосбор команд.
Основные правила: дедлайн - 18 января 2027 года, технода - IHP 130 nm CMOS5L, площадь - примерно 1 мм^2.
Остальные подробности смотрите в блоге Jane Street.
https://blog.janestreet.com/protocol-emulator-asic-competition/
Задача довольно интересная: сделать general-purpose protocol emulator ASIC.
Идея в том, чтобы вместо отдельных UART, SPI и I2C контроллеров сделать универсальный программируемый контроллер, способный через GPIO реализовывать разные, в том числе кастомные, протоколы уже после изготовления чипа.
Первое, что тут приходит в голову, - PIO из Raspberry Pi RP2040. Собственно, сами Jane Street тоже приводят его в качестве одного из источников вдохновения.
https://rp2040pio-docs.readthedocs.io/en/latest/pio-programs.html
И тут, мне кажется, самое важное понять, где заканчивается FSM и начинается микроконтроллер 😁
Пару слов о формате. Когда задачка выходит за рамки одного дня, как мне кажется, она превращается из интересной головоломки в полноценный сайд-проект. Наверное, единственное, что подкупает в этом челлендже - Jane Street обещают затейпаутить самые интересные решения и отправить готовые чипы разработчикам. Честная это компенсация за такой объём работы или нет - решайте сами.
Если решили поучаствовать, в комментариях к посту можно найти единомышленников и организовать самосбор команд.
Основные правила: дедлайн - 18 января 2027 года, технода - IHP 130 nm CMOS5L, площадь - примерно 1 мм^2.
Остальные подробности смотрите в блоге Jane Street.
https://blog.janestreet.com/protocol-emulator-asic-competition/
❤
7
🔥
5
Пост от 11.09.2026 18:43
926
0
46
Запуск нейросетей на ПЛИС. Краевой ИИ. Академическая деятельность
В тридцать втором выпуске «Битовых масок» Антон Афанасьев и Алина Галичина разбираются в краевом искусственном интеллекте вместе с Иваном Дейнекой — заведующим лабораторией Высшей инженерно-технической школы ИТМО. Иван совмещает три роли сразу: инженерную, научную и преподавательскую, а его команда размещает нейросети на ПЛИС и системах на кристалле.
Гость объяснил, почему ПЛИС выигрывают у связки CPU с NPU, когда сеть нестандартная, и почему память, а не вычислители, оказывается главным ограничением. Рассказал, как из университетского проекта волоконно-оптического гироскопа выросли лаборатории института, зачем инженеру статический временной анализ и что делать, если проект не помещается в кристалл.
Среди тем подкаста:
➡️ зачем встраивать нейросеть-триггер прямо в ПЛИС, чтобы поймать редкий баг;
➡️ когда нужна ПЛИС, а когда хватит микроконтроллера;
➡️ почему статический временной анализ пропускают и чем это заканчивается;
➡️ что делать, если проект не помещается в кристалл;
➡️ какие модели уже разместили на ПЛИС: MLP, сверточные сети, трансформеры;
➡️ почему память, а не вычислители, ограничивает нейросети на ПЛИС;
➡️ как из университетского проекта вырастают лаборатории и производство.
Полезные ссылки:
🔗GitHub лаборатории Высшей инженерно-технической школы ИТМО
🔗доклад Ивана Дейнеки «Edge AI на ПЛИС: тенденции и руководство по размещению»
🔗выпуск «Битовых масок» о верификации, open source и AI с Богданом Колбовым
🔗выпуск «Битовых масок» о спецпроцессорах с Петром Советовым
Смотреть или слушать
RUTUBE
VK
YOUTUBE
Я.Музыка
❓Помогите развитию подкаста: пройдите наш опрос
В тридцать втором выпуске «Битовых масок» Антон Афанасьев и Алина Галичина разбираются в краевом искусственном интеллекте вместе с Иваном Дейнекой — заведующим лабораторией Высшей инженерно-технической школы ИТМО. Иван совмещает три роли сразу: инженерную, научную и преподавательскую, а его команда размещает нейросети на ПЛИС и системах на кристалле.
Гость объяснил, почему ПЛИС выигрывают у связки CPU с NPU, когда сеть нестандартная, и почему память, а не вычислители, оказывается главным ограничением. Рассказал, как из университетского проекта волоконно-оптического гироскопа выросли лаборатории института, зачем инженеру статический временной анализ и что делать, если проект не помещается в кристалл.
Среди тем подкаста:
➡️ зачем встраивать нейросеть-триггер прямо в ПЛИС, чтобы поймать редкий баг;
➡️ когда нужна ПЛИС, а когда хватит микроконтроллера;
➡️ почему статический временной анализ пропускают и чем это заканчивается;
➡️ что делать, если проект не помещается в кристалл;
➡️ какие модели уже разместили на ПЛИС: MLP, сверточные сети, трансформеры;
➡️ почему память, а не вычислители, ограничивает нейросети на ПЛИС;
➡️ как из университетского проекта вырастают лаборатории и производство.
Полезные ссылки:
🔗GitHub лаборатории Высшей инженерно-технической школы ИТМО
🔗доклад Ивана Дейнеки «Edge AI на ПЛИС: тенденции и руководство по размещению»
🔗выпуск «Битовых масок» о верификации, open source и AI с Богданом Колбовым
🔗выпуск «Битовых масок» о спецпроцессорах с Петром Советовым
Смотреть или слушать
RUTUBE
VK
YOUTUBE
Я.Музыка
❓Помогите развитию подкаста: пройдите наш опрос
Изображение
👍
10
🔥
7
Пост от 04.09.2026 22:26
256
1
11
Продолжая рфсоковое: Alinx показала новую плату HEA47: на ней встретились RFSoC ZU47DR и NVIDIA Jetson AGX Orin/Thor через PCIe Gen3 x8
пока только на китайской версии сайта с ценой ¥100000.00
пока только на китайской версии сайта с ценой ¥100000.00
Изображение
🔥
6
Пост от 04.09.2026 19:03
181
0
7
#вакансия #SignalProcessing #DSP #SerDes #CoherentOptics #FPGA #semiconductor #photonics #AIhardware #Paris #relocation
🔸 Signal Processing Engineer
🔸 Компания: Arago
🔸 Локация: Париж 🇫🇷; помогаем с релокацией начиная от визы и поиска жилья.
🔸 Занятость: full-time
🔸 Формат: on-site (Париж)
🔸 Уровень: middle/senior, конкурентная компенсация + значимый equity
Arago — французский deep-tech стартап. Строим AI-inference серверы на прорыве в co-packaged optics: архитектура уже taped out и снижает стоимость $/M токенов в 10–30×. Работаем в stealth, есть контракты с AI-лабами, подняли $100M+ от Tier-1 VC и полупроводниковых ветеранов.
Ищем Signal Processing инженера на стык физического и цифрового слоёв: переводишь железную реальность в математическую ясность. Работаешь руками с optics / analog / digital командами над со-оптимизацией compute engine. Твой основной инструмент — C/C++.
🔸 Задачи:
— Разрабатывать DSP-алгоритмы (FFE/DFE/CTLE, adaptive filtering, channel estimation, CDR, FFT, dispersion compensation, MIMO, beamforming, pulse compression) — от математики до продакшн-кода
— Переводить hardware-решения optics/analog/digital команд в модели, влияющие на чип и качество AI-модели
— Строить внутренние инструменты для симуляции и оптимизации железа
— Моделировать шум, искажения сигнала и light-matter interaction, давать математическое обоснование архитектурным решениям
🔸 Требования:
— От 2 лет hands-on разработки DSP-алгоритмов (не менеджмент/интеграция/тестирование) — приоритетный бэкграунд: coherent optics или SerDes/high-speed transceivers
— Сильная математическая база: linear algebra, probability/estimation theory, optimization, numerical methods
— MSc/PhD Applied Math, EE, Physics)
— Python (NumPy/SciPy) для прототипирования и моделирования алгоритмов
— C/C++ как основной инструмент — production-реализация (low-latency / embedded / FPGA-host)
— Разговорный английский
🔸 Контакт: TG @AnnPaMi (Анна) · anna.miroshnichenko@arago.inc
🔸 Signal Processing Engineer
🔸 Компания: Arago
🔸 Локация: Париж 🇫🇷; помогаем с релокацией начиная от визы и поиска жилья.
🔸 Занятость: full-time
🔸 Формат: on-site (Париж)
🔸 Уровень: middle/senior, конкурентная компенсация + значимый equity
Arago — французский deep-tech стартап. Строим AI-inference серверы на прорыве в co-packaged optics: архитектура уже taped out и снижает стоимость $/M токенов в 10–30×. Работаем в stealth, есть контракты с AI-лабами, подняли $100M+ от Tier-1 VC и полупроводниковых ветеранов.
Ищем Signal Processing инженера на стык физического и цифрового слоёв: переводишь железную реальность в математическую ясность. Работаешь руками с optics / analog / digital командами над со-оптимизацией compute engine. Твой основной инструмент — C/C++.
🔸 Задачи:
— Разрабатывать DSP-алгоритмы (FFE/DFE/CTLE, adaptive filtering, channel estimation, CDR, FFT, dispersion compensation, MIMO, beamforming, pulse compression) — от математики до продакшн-кода
— Переводить hardware-решения optics/analog/digital команд в модели, влияющие на чип и качество AI-модели
— Строить внутренние инструменты для симуляции и оптимизации железа
— Моделировать шум, искажения сигнала и light-matter interaction, давать математическое обоснование архитектурным решениям
🔸 Требования:
— От 2 лет hands-on разработки DSP-алгоритмов (не менеджмент/интеграция/тестирование) — приоритетный бэкграунд: coherent optics или SerDes/high-speed transceivers
— Сильная математическая база: linear algebra, probability/estimation theory, optimization, numerical methods
— MSc/PhD Applied Math, EE, Physics)
— Python (NumPy/SciPy) для прототипирования и моделирования алгоритмов
— C/C++ как основной инструмент — production-реализация (low-latency / embedded / FPGA-host)
— Разговорный английский
🔸 Контакт: TG @AnnPaMi (Анна) · anna.miroshnichenko@arago.inc