Не попадитесь на накрученные каналы! Узнайте, не накручивает ли канал просмотры или
подписчиков
Проверить канал на накрутку


Телеграм канал «Клуб CDO»

Клуб CDO
3.0K
1.6K
249
145
8.1K
Сообщество профессионалов в области работы с данными и искуственным интеллектом
Подписчики
Всего
4 129
Сегодня
0
Просмотров на пост
Всего
820
ER
Общий
19.87%
Суточный
15.45%
Динамика публикаций

Telemetr - сервис глубокой аналитики
телеграм-каналов
телеграм-каналов

Получите подробную информацию о каждом канале
Отберите самые эффективные каналы для
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам

Анализируйте рекламные посты
и креативы
и креативы
Узнайте какие посты лучше сработали,
а какие хуже, даже если их давно удалили
а какие хуже, даже если их давно удалили

Оценивайте эффективность тематики и контента
Узнайте, какую тематику лучше не рекламировать
на канале, а какая зайдет на ура
на канале, а какая зайдет на ура

Показано 7 из 3 040 постов
Смотреть все посты
Пост от 26.10.2026 10:36
90
0
3
Дайджест статей
📰 «Донащупывая» Data Lineage
🔗 https://habr.com/ru/articles/1095988/
💡 Строй lineage как DAG состояний данных, а не таблиц: UPDATE в ту же таблицу перестаёт давать циклы.
📰 Как мы делали «золотой датасет» для оценки агентов
🔗 https://habr.com/ru/companies/alfa/articles/1095638/
💡 Давай разметчикам тот же срез базы, что у DS, и сначала меряй, какую долю потока RAG вообще покрывает.
📰 Возможности сводных таблиц в Superset
🔗 https://habr.com/ru/articles/1094848/
💡 Для KPI-карточек в Superset 6 нумеруй города внутри региона и клади HTML-метрику в ячейку pivot.
📰 Как мы в AI VK рекомендации на стримы делили
🔗 https://habr.com/ru/companies/vk/articles/1096708/
💡 Дели пайплайн по задачам, а не по коду: общие кубики плюс кеш дают разделение без роста ресурсов.
📰 Пять граней диагностики Data Lakehouse: концепция единого рабочего места
🔗 https://habr.com/ru/articles/1097000/
💡 Пока нет observability, собери lineage+Gantt+Iceberg-checks+Spark Event Log в одном дашборде за недели.
📰 RAG под защитой: как не превратить корпоративную базу знаний в канал утечки
🔗 https://habr.com/ru/companies/infera_security/articles/1097220/
💡 Вектора не знают прав: фильтруй фрагменты по ACL до модели и защищай эмбеддинги как исходники.
📰 Лучшие ИИ для визуализации данных 2026: нейросети для графиков, диаграмм, дашбордов и схем
🔗 https://habr.com/ru/companies/karpov_courses/articles/1098518/
💡 Перед графиком от ИИ проверь полноту периода, дубли и метрику - красивый график не равен верному расчёту.
📰 RAG-бот по материалам эксперта: как я мерил качество поиска и почему гибрид оказался хуже чистого вектора
🔗 https://habr.com/ru/articles/1091058/
💡 Проверяй «гибрид лучше вектора» на своём стенде: шумный BM25 в RRF уронил semantic recall с 42% до 25%.
📰 ИИ-джинн должен сидеть в «лампе» или как мы нормализовали миллионы записей номенклатуры на обычном сервере
🔗 https://habr.com/ru/articles/1098614/
💡 Для НСИ бери извлекающие BERT/NER на CPU и правила, а LLM оставь на разметку: промпт - та же хрупкая regex.
📰 AI Changes the Data Interface, Not the Query Engine
🔗 https://www.infoq.com/articles/ai-changes-data-interface/
💡 Цифры считает DuckDB, агент только интерпретирует fact packet; lakehouse нужен при общих потребителях и ТБ.
📰 Why AI Agents Need a Shared Enterprise Ontology
🔗 https://dzone.com/articles/ai-agent-shared-ontology
💡 MCP и A2A не дают общего смысла: заведи федеративную онтологию сущностей, агентов и политик с версиями.
📰 How We Migrated Europe's Largest Data Lake: On Time and Without Turning the Lights Off
🔗 https://medium.com/booking-com-development/how-we-migrated-europes-largest-data-lake-on-time-and-without-turning-the-lights-off-61ee8a07db76
💡 Мигрируй волнами с копированием промежуточных таблиц, чтобы команды не ждали цепочку, и выкинь ненужное.
👍
1
Пост от 24.10.2026 16:57
502
3
2
А вот и автор алгоритмов Джон Ромеро (создатель 2-х оригинальных игр Doom) с редакцией :)


🔥
20
👍
5
🤝
2
Пост от 23.10.2026 09:57
210
0
4
С середины года все вендоры дружно сменили вывески: была CDP, стала Agentic CDP. При этом даже CDP Institute признаёт, что это не новая категория, а эволюция класса продукта. Сбор данных, единый профиль, идентификация, активация - всё на месте.
Дмитрий Изместьев из нашей команды CleverDATA разобрал это в интервью TAdviser.
Раньше маркетолог был оператором: собрал сегмент, написал правило, настроил триггер, посмотрел на дашборд, повторил. Теперь он ставит цели и принимает результат. Сегменты, гипотезы, сборку коммуникации и даже проверку ссылок делает агент. Непрерывно, а не от кампании к кампании.
Разницу хорошо видно на примере из интервью. Фитнес-клуб хочет каждый день находить клиентов, у которых через месяц заканчивается абонемент, и предлагать им продление со скидкой. Задача банальная. Но в классической CDP это либо ручная пересборка сегмента каждое утро, либо тикет разработчикам. В проактивной её достаточно один раз одобрить, дальше она работает сама.
Но многие слышат слово "агент" и делают вывод: зачем CDP, если есть LLM? Отдадим модели клиентскую базу, пусть разбирается. На выходе получают счёт за токены и персональные данные, которые ушли туда, куда не должны были. Пилот без болида - это просто человек в красивом комбинезоне.
Ценность агента целиком определяется тем, что лежит под ним: качеством единого профиля, точностью идентификации и контуром, который не выпускает персональные данные наружу. Модель здесь - самая маленькая часть системы. Её можно поменять сравнительно легко. Чистые данные и архитектуру контуров быстро не соберёшь.
Это работает и в обратную сторону. Дмитрий приводит хорошее определение: ИИ - отличная технология, которая на основе ваших ошибочных данных помогает прийти к неверным решениям в разы быстрее и с прекрасным оформлением. Поэтому онбординг проактивной CDP - не формальность. Если отвечать на вопросы про цели и KPI отписками, агент будет очень продуктивно оптимизировать не то.
Agentic CDP - это не про агентов. Это про то, что у компаний наконец появился повод навести порядок в клиентских данных. Те, кто годами строил нормальный профиль клиента, получают агента как бонус. Остальные получают дорогую машину, которая очень быстро делает ерунду.
https://www.tadviser.ru/a/974329
😁
2
👍
1
Пост от 22.10.2026 09:31
197
0
10
На Хабре вышел перевод статьи Сэма Роуза из ngrok про механизм работы процесса кэширования тоненов. Попутно она объясняет, как вообще устроена LLM.
Очень хорошая и глубокая статья. Без этого понимания к модели, на мой взгляд, лучше не подходить: промпт-инженерия превращается в заклинания, а счёт за API - в сюрприз.
Первое, что ломает интуицию: кэшируется не ответ. Отправьте один и тот же промпт десять раз и получите десять разных ответов, хотя в usage будет написано, что входные токены взяты из кэша.
Кэширование происходит внутри механизма attention. Attention разобран на примере “Mary had a little” с реальными весами GPT-2. Каждый токен смешивает эмбеддинги предыдущих в пропорции их важности, а маска с минус бесконечностью не даёт будущему влиять на прошлое. На простом наблюдении держится вся экономика. Модель генерирует по одному токену и на каждой итерации прогоняет весь контекст заново. При этом веса уже обработанных токенов не меняются. Значит, матрицы K и V можно посчитать один раз, сохранить и дальше считать только новую строку. Это и есть KV-кэш. Провайдеры держат его 5-10 минут после запроса.
Из этого следуют инженерные выводы, которые полезнее любого гайда по промптам:
• Совпадение работает по префиксу. Стабильная часть промпта должна идти первой, всё изменчивое - в конец. Если сдвинуть один символ в начале, платишь полную цену.
• Temperature, top_p и top_k кэш не ломают. Они работают уже после attention, на этапе выбора токена.
У вендоров разная философия. OpenAI кэширует автоматически, и в тестах автора попадание было около 50%. Anthropic даёт явный контроль за доплату и попадает в 100% случаев. Для длинных контекстов, где нужна предсказуемая задержка, это архитектурное решение.
https://habr.com/ru/articles/978498/
👍
2
Пост от 22.10.2026 08:40
152
0
7
⚡️Как изменился российский рынок каталогов данных за три года?
В 2023 году мы уже исследовали российский рынок Data Catalog. За три года класс решений заметно изменился: каталог данных перестал быть просто справочником технических метаданных и всё чаще становится инфраструктурой доверия к данным – связывает происхождение и качество данных, бизнес-контекст, владельцев, правила управления и процессы работы с данными.
В новом исследовании «Data Catalog-круг Громова 2026» мы рассмотрели 7 российских платформ: Arenadata Catalog, SBF DataManagement, RT.DataGovernance, Data Ocean Governance, Q.DataCatalog, VK Data Catalog и Юнидата. Отдельно представили профиль Axenix Dat .ax Meta, а OpenMetadata использовали как референсную платформу вне сравнительного контура.
➡️ Свежий отчёт поможет разобраться:
– чем российские Data Catalog отличаются по глубине функциональности, архитектуре и зрелости эксплуатации,
– насколько хорошо они интегрируются в корпоративный ИТ-ландшафт и соответствуют требованиям безопасности и импортозамещения,
– какие возможности есть для управления доступом, аудита и работы в закрытых контурах,
– какие возможности ИИ уже реализованы на практике,
– как выбрать платформу под свои задачи и подготовить пилот.
❗️Все решения проверены по 325 критериям: оценивается не только заявленный функционал, но и глубина реализации и степень его подтверждения документацией и демонстрациями.
Какие тренды мы увидели:
1️⃣ Data Catalog становится навигатором по корпоративным данным – показывает, где находятся данные, как они связаны, кто за них отвечает и насколько им можно доверять.
2️⃣ Отдельный тренд – ИИ. Каталоги становятся источником контекста для ИИ-агентов, при этом зрелость AI/ML-функций у российских решений сильно различается: от 23 до 94 баллов из 100.
3️⃣ Ключевой тренд – базовые функции стали стандартом, а конкуренция смещается в глубину: автоматизацию lineage, качество коннекторов, масштабируемость, аудит и зрелость эксплуатации.
Сохраните себе отчёт, чтобы быстро ориентироваться в российском рынке каталогов данных в 2026 году и сформировать шорт-лист решений для своей компании.
📌 Исследование поможет выбрать Data Catalog-платформу с учётом задач, архитектуры и зрелости управления данными в организации – скачать исследование!
Обсудить исследование: telemetr.me/gromovcircles_chat/167/242
Круги Громова | Подписаться и стать частью Data-сообщества ⬅️
#КругиГромова #DataCatalog #DataGovernance #исследование_КругиГромова
👍
2
❤
1
👎
1
💩
1
Пост от 21.10.2026 14:49
151
0
3
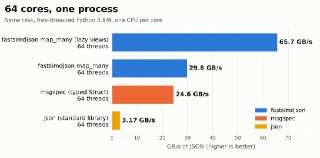
В копилку тем, кто много работает с json. Кажется интересная либа
https://lemire.me/blog/2026/10/12/parsing-json-at-tens-of-gigabytes-per-second-in-python/
https://lemire.me/blog/2026/10/12/parsing-json-at-tens-of-gigabytes-per-second-in-python/
🤝
2
Пост от 21.10.2026 10:15
129
0
4
Нашёл хорошую подборку докладов: записи конференции CONTEXT 2025 от DataHub.
Полторы тысячи человек из data и AI, дюжина сессий, и почти все спикеры - практики из компаний, где агенты работают в проде, а не только в презентациях.
Да, мероприятие вендорское, и термин context management продвигает компания, которая продаёт платформу с таким названием. Но спикеры рассказывают про свою инфраструктуру, а не про чужой продукт, и этим записи ценны.
Что стоит посмотреть:
- Apple - агенты как «цифровые стюарды» каталога данных. Они сами находят пробелы в метаданных, пишут правила качества данных и подстраивают процессы под новые политики. При этом человек остаётся в контуре, без иллюзий про полную автономию.
- Netflix - каталог всех технических активов, а не только данных: API, модели, метрики. Логика простая: то, что строишь для людей сегодня, завтра станет контекстом для агентов.
- Robinhood и Block - end-to-end lineage. Robinhood автоматизировал GDPR-проверки по всему озеру данных и за счёт этого вышел в UK и EU. Block теперь заранее оценивает blast radius перед удалением данных.
- Webster Bank и Valley Bank - про BCBS 239. Самая сильная мысль конференции, на мой взгляд: регулятору и AI-агенту нужно одно и то же, а именно трассируемые и управляемые данные. Строишь один раз, получаешь пользу дважды.
- Mikhael Mazu - миграция клиринговой системы, которой 17 лет и которая обслуживала 36 бизнесов. Полгода ушло только на архитектуру метаданных, зато проект, рассчитанный на 36 месяцев, закрыли за 22.
- João Moura из CrewAI - о том, почему 95% AI-пилотов проваливаются. Его ответ: мешают люди, а не технологии.
- Ещё в программе Jeff Weiner о скорости и качестве решений и неожиданный Alex Pall из The Chainsmokers. Он рассказывает, как метаданные возвращают музыкантам права и деньги. Та же задача атрибуции стоит перед каждым, кто прогоняет данные через training pipeline.
Общий вывод я бы сформулировал так: выигрывают не те, у кого лучше модель, а те, у кого порядок в контексте. Lineage, каталог, governance внутри рабочего процесса разработчика - скучная инфраструктура, без которой агент остаётся демкой.
Все записи в открытом доступе: datahub.com/resources/context/
👍
2