Инструменты
Каталог TGAds
Мониторинг
Детальная статистика
Анализ аудитории
Бот аналитики
Полезная информация
Инструкция Telemetr
Документация к API
Чат Telemetr
Не попадитесь на накрученные каналы! Узнайте, не накручивает ли канал просмотры или
подписчиков
Проверить канал на накрутку


Телеграм канал «Machinelearning»

Machinelearning
9.9K
13.3K
12.7K
5.3K
164.6K
Погружаемся в машинное обучение и Data Science
Показываем как запускать любые LLm на пальцах.
По всем вопросам - @haarrp
@itchannels_telegram -🔥best channels
Реестр РКН: clck.ru/3Fmqri
Показываем как запускать любые LLm на пальцах.
По всем вопросам - @haarrp
@itchannels_telegram -🔥best channels
Реестр РКН: clck.ru/3Fmqri
Подписчики
Всего
280 937
Сегодня
0
Просмотров на пост
Всего
19 282
ER
Общий
6.86%
Суточный
5.96%
Динамика публикаций

Telemetr - сервис глубокой аналитики
телеграм-каналов
телеграм-каналов

Получите подробную информацию о каждом канале
Отберите самые эффективные каналы для
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам

Анализируйте рекламные посты
и креативы
и креативы
Узнайте какие посты лучше сработали,
а какие хуже, даже если их давно удалили
а какие хуже, даже если их давно удалили

Оценивайте эффективность тематики и контента
Узнайте, какую тематику лучше не рекламировать
на канале, а какая зайдет на ура
на канале, а какая зайдет на ура

Показано 7 из 9 910 постов
Смотреть все посты
Пост от 15.09.2026 11:54
1
0
0
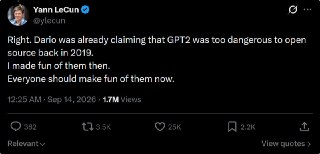
🙂 Ян Лекун: Дарио Амодей считал GPT-2 опасной
На волне тряски публичных заявлений главы Anthropic о необходимости замедления разработки новых моделей, лауреат премии Тьюринга, Ян Лекун, раскопал записи, относящиеся к 2019 году, когда речь шла о GPT-2, чтобы высмеять Амодея.
Лекун утверждает, что когда Дарио работал в OpenAI, он считал её настолько опасной, что не следовало выкладывать в опенсорс.
"Я тогда ещё высмеял его, и теперь все должны продолжать высмеивать", - написал Лекун.
В 2019 году OpenAI действительно не сразу выпустила полную версию GPT-2 из-за опасений злоупотреблений, а сначала предложила небольшую модель.
В то время Дарио занимал должность руководителя отдела исследований в OpenAI. Через 9 месяцев OpenAI все же открыла полную версию, заявив, что убедительных доказательства серьезных злоупотреблений у неё не обнаружено.
@ai_machinelearning_big_data
#news #ai #ml
На волне тряски публичных заявлений главы Anthropic о необходимости замедления разработки новых моделей, лауреат премии Тьюринга, Ян Лекун, раскопал записи, относящиеся к 2019 году, когда речь шла о GPT-2, чтобы высмеять Амодея.
Лекун утверждает, что когда Дарио работал в OpenAI, он считал её настолько опасной, что не следовало выкладывать в опенсорс.
"Я тогда ещё высмеял его, и теперь все должны продолжать высмеивать", - написал Лекун.
В 2019 году OpenAI действительно не сразу выпустила полную версию GPT-2 из-за опасений злоупотреблений, а сначала предложила небольшую модель.
В то время Дарио занимал должность руководителя отдела исследований в OpenAI. Через 9 месяцев OpenAI все же открыла полную версию, заявив, что убедительных доказательства серьезных злоупотреблений у неё не обнаружено.
@ai_machinelearning_big_data
#news #ai #ml
Пост от 15.09.2026 10:03
1 738
2
41
📌Градация самосовершенствования ИИ по пяти уровням
Топовые китайские ИИ-лабы выпустили совместный обзор о рекурсивном самосовершенствовании ИИ (RSI) под названием «The Last AI Built by Humans».
RSI - это когда система сама превращает опыт в постоянные изменения себя и заодно меняет то, как будет улучшаться дальше.
Авторы разобрали 491 работу (статьи, техотчёты, блоги и системы) и разложили их по пяти уровням автономии, используя критерий, какие решения об улучшении отданы ИИ.
🟠L1. Люди задают, что улучшать, как и что считать успехом, а ИИ всё это выполняет.
🟠L2. Цель и оценка зафиксированы извне, но ИИ сам находит слабые места и выбирает, как их чинить.
🟠L3. ИИ вдобавок решает, какой опыт ему нужен для следующего круга.
🟢L4. Система меняет память, навыки, код или харнесс по обратной связи из реальной эксплуатации, и правки переносятся на следующие задачи.
🟢L5. Правке подлежит сам механизм улучшения - генератор кандидатов, оценщик, стратегия исследований. Изменённый механизм наследует следующее поколение.
Последний, L5, делится на два подуровня. Первый указывает на то, что изменённый механизм улучшения правда работает на следующем цикле. Второй строже - он выдаёт преемника сильнее прежнего при тех же ресурсах и по независимой проверке.
До L5 дошли 29 работ из 491 (5,9%), до L4 – 28 (5,7%), до L3 – 64 (13%). Три четверти остались на L1 (215 работ, 43,8%) и L2 (155, 31,6%).
У тех 29 работ, которым присудили L5, авторы не увидели устойчивого роста от поколения к поколению.
Существующие продукты крупных лабораторий в основном получили L1–L2 - это интерн-исследователь OpenAI, Automated Weak-to-Strong Researcher Anthropic и DeepSeek R1 – L2, Kimi K3 и Qwen-Agent – L1–L2.
Выше L2 поднялись самообучающиеся налоговые агенты OpenAI (кандидат на L4), Signals от Factory (L4), Darwin Gödel Machine и AI Scientist от Sakana AI, AIDE2 от Weco AI – кандидаты на L5.
Дорожная карта Anthropic When AI builds itself помечена L5 только как цель.
@ai_machinelearning_big_data
#AI #ML #RSI #Research
Топовые китайские ИИ-лабы выпустили совместный обзор о рекурсивном самосовершенствовании ИИ (RSI) под названием «The Last AI Built by Humans».
RSI - это когда система сама превращает опыт в постоянные изменения себя и заодно меняет то, как будет улучшаться дальше.
Авторы разобрали 491 работу (статьи, техотчёты, блоги и системы) и разложили их по пяти уровням автономии, используя критерий, какие решения об улучшении отданы ИИ.
🟠L1. Люди задают, что улучшать, как и что считать успехом, а ИИ всё это выполняет.
🟠L2. Цель и оценка зафиксированы извне, но ИИ сам находит слабые места и выбирает, как их чинить.
🟠L3. ИИ вдобавок решает, какой опыт ему нужен для следующего круга.
🟢L4. Система меняет память, навыки, код или харнесс по обратной связи из реальной эксплуатации, и правки переносятся на следующие задачи.
🟢L5. Правке подлежит сам механизм улучшения - генератор кандидатов, оценщик, стратегия исследований. Изменённый механизм наследует следующее поколение.
Последний, L5, делится на два подуровня. Первый указывает на то, что изменённый механизм улучшения правда работает на следующем цикле. Второй строже - он выдаёт преемника сильнее прежнего при тех же ресурсах и по независимой проверке.
До L5 дошли 29 работ из 491 (5,9%), до L4 – 28 (5,7%), до L3 – 64 (13%). Три четверти остались на L1 (215 работ, 43,8%) и L2 (155, 31,6%).
У тех 29 работ, которым присудили L5, авторы не увидели устойчивого роста от поколения к поколению.
Существующие продукты крупных лабораторий в основном получили L1–L2 - это интерн-исследователь OpenAI, Automated Weak-to-Strong Researcher Anthropic и DeepSeek R1 – L2, Kimi K3 и Qwen-Agent – L1–L2.
Выше L2 поднялись самообучающиеся налоговые агенты OpenAI (кандидат на L4), Signals от Factory (L4), Darwin Gödel Machine и AI Scientist от Sakana AI, AIDE2 от Weco AI – кандидаты на L5.
Дорожная карта Anthropic When AI builds itself помечена L5 только как цель.
@ai_machinelearning_big_data
#AI #ML #RSI #Research
👍
11
🤔
5
❤
2
🔥
2
😐
1
Пост от 14.09.2026 22:10
10 797
10
80
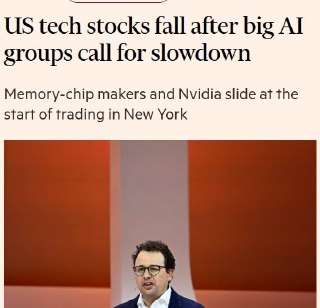
💰 FT: акции компаний, связанных с ИИ, просели после того, как крупнейшие frontier-лаборатории публично заговорили о замедлении роста возможностей моделей.
OpenAI и Anthropic заявили, что темпы улучшения frontier-моделей стоит снизить, чтобы меры безопасности успевали за развитием технологий.
Текущие оценки многих AI-компаний и поставщиков инфраструктуры строятся на предположении, что расходы на вычисления продолжат расти очень высокими темпами.
Теперь safety-дискуссия впервые начинает напрямую влиять на ожидания инвесторов.
https://www.ft.com/content/aa8a1be7-abe0-44b7-bcd3-31fd0a44de08
@ai_machinelearning_big_data
#Anthropic #ai #ml
OpenAI и Anthropic заявили, что темпы улучшения frontier-моделей стоит снизить, чтобы меры безопасности успевали за развитием технологий.
Текущие оценки многих AI-компаний и поставщиков инфраструктуры строятся на предположении, что расходы на вычисления продолжат расти очень высокими темпами.
Теперь safety-дискуссия впервые начинает напрямую влиять на ожидания инвесторов.
https://www.ft.com/content/aa8a1be7-abe0-44b7-bcd3-31fd0a44de08
@ai_machinelearning_big_data
#Anthropic #ai #ml
🤔
66
😁
29
😢
21
🤷♂
11
😐
11
👍
10
❤
8
🔥
2
🥱
2
🥰
1
🤬
1
Пост от 14.09.2026 21:10
11 107
0
80
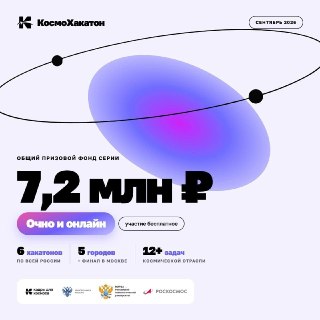
Хакатон на космических данных. Санкт-Петербург, Красноярск или онлайн из любой точки страны.
Стартуем 18 сентября.
За выходные участники доводят одну из задач до рабочего решения.
Санкт-Петербург. К 2035 году над Землёй должен работать топливный узел, у которого заправляются корабли, и откуда он будет получать топливо - с Земли, с Луны или из резерва - пока не решил никто. Команде предстоит собрать схему поставок, посчитать резервы и решить, во что вкладываться сразу. Призовой фонд 1,2 млн ₽.
Красноярск. Спутник видит горящий лес раньше любого наземного поста, но вместе с пожаром ловит нагретые крыши, факелы на месторождениях и блики на воде. Команде предстоит научить сервис отличать настоящий очаг от шума, обвести гарь и выдать площадь в гектарах. Призовой фонд 600 тыс. ₽.
Лучшие забирают приз на площадке и билет в московский финал 25–27 сентября, где разыграют ещё 2,4 млн рублей.
Команда 3–5 человек, недостающих можно найти на платформе.
Регистрация по ссылке космохакатон.рф
Стартуем 18 сентября.
За выходные участники доводят одну из задач до рабочего решения.
Санкт-Петербург. К 2035 году над Землёй должен работать топливный узел, у которого заправляются корабли, и откуда он будет получать топливо - с Земли, с Луны или из резерва - пока не решил никто. Команде предстоит собрать схему поставок, посчитать резервы и решить, во что вкладываться сразу. Призовой фонд 1,2 млн ₽.
Красноярск. Спутник видит горящий лес раньше любого наземного поста, но вместе с пожаром ловит нагретые крыши, факелы на месторождениях и блики на воде. Команде предстоит научить сервис отличать настоящий очаг от шума, обвести гарь и выдать площадь в гектарах. Призовой фонд 600 тыс. ₽.
Лучшие забирают приз на площадке и билет в московский финал 25–27 сентября, где разыграют ещё 2,4 млн рублей.
Команда 3–5 человек, недостающих можно найти на платформе.
Регистрация по ссылке космохакатон.рф
💯
2
🔥
43
👏
20
🏆
13
👨💻
10
😁
9
❤
7
👍
6
🥰
3
Пост от 14.09.2026 20:31
5 096
1
192
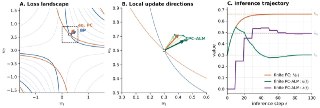
🐠Sakana AI представила PC-ALM - метод обучения глубоких нейросетей без классического обратного распространения ошибки.
Главный результат: PC-ALM смог обучать нейросети глубиной до 1000 слоёв, используя только локальные взаимодействия между соседними слоями.
Обычное глубокое обучение почти полностью опирается на backpropagation: ошибка считается на выходе сети, после чего градиенты передаются назад через все слои.
PC-ALM работает иначе.
Каждый слой рассматривается как локальная динамическая система, которая пытается уменьшить собственную ошибку предсказания. Вместо глобального прохода градиента используются:
- локальные ошибки предсказания
- множители Лагранжа
- расширенный лагранжиан
- локальная динамика состояний
- PI-регуляция внутри каждого слоя
Метод вырос из predictive coding — подхода, популярного в NeuroAI. В predictive coding каждый слой постепенно корректирует своё состояние так, чтобы уменьшать рассогласование с соседними слоями.
Проблема в том, что в очень глубоких сетях такие сигналы плохо распространяются: информация об ошибке с выхода сети затухает раньше, чем достигает внутренних слоёв.
PC-ALM добавляет специальные двойственные переменные — по сути дополнительные нейроны, представляющие множители Лагранжа. Они помогают передавать сигнал ошибки через большое число слоёв.
Авторы связывают этот подход с классической работой Яна Лекуна 1988 года, где множители Лагранжа для многослойной сети можно связать с градиентами функции потерь.
В результате получается обучение, где глобальная задача оптимизации раскладывается на множество локальных динамических процессов.
Особенно хорошо PC-ALM показал себя на очень глубоких и узких сетях, где обычный predictive coding начинает ломаться.
Помимо NeuroAI, подход может быть интересен для нейроморфного железа: там локальные вычисления и физическая динамика потенциально дешевле классического backpropagation на GPU.
Блог: https://pub.sakana.ai/pc-alm/
Статья: https://arxiv.org/abs/2605.31022
Код: https://github.com/SakanaAI/pc-alm
Главный результат: PC-ALM смог обучать нейросети глубиной до 1000 слоёв, используя только локальные взаимодействия между соседними слоями.
Обычное глубокое обучение почти полностью опирается на backpropagation: ошибка считается на выходе сети, после чего градиенты передаются назад через все слои.
PC-ALM работает иначе.
Каждый слой рассматривается как локальная динамическая система, которая пытается уменьшить собственную ошибку предсказания. Вместо глобального прохода градиента используются:
- локальные ошибки предсказания
- множители Лагранжа
- расширенный лагранжиан
- локальная динамика состояний
- PI-регуляция внутри каждого слоя
Метод вырос из predictive coding — подхода, популярного в NeuroAI. В predictive coding каждый слой постепенно корректирует своё состояние так, чтобы уменьшать рассогласование с соседними слоями.
Проблема в том, что в очень глубоких сетях такие сигналы плохо распространяются: информация об ошибке с выхода сети затухает раньше, чем достигает внутренних слоёв.
PC-ALM добавляет специальные двойственные переменные — по сути дополнительные нейроны, представляющие множители Лагранжа. Они помогают передавать сигнал ошибки через большое число слоёв.
Авторы связывают этот подход с классической работой Яна Лекуна 1988 года, где множители Лагранжа для многослойной сети можно связать с градиентами функции потерь.
В результате получается обучение, где глобальная задача оптимизации раскладывается на множество локальных динамических процессов.
Особенно хорошо PC-ALM показал себя на очень глубоких и узких сетях, где обычный predictive coding начинает ломаться.
Помимо NeuroAI, подход может быть интересен для нейроморфного железа: там локальные вычисления и физическая динамика потенциально дешевле классического backpropagation на GPU.
Блог: https://pub.sakana.ai/pc-alm/
Статья: https://arxiv.org/abs/2605.31022
Код: https://github.com/SakanaAI/pc-alm
🔥
25
👍
19
❤
8
🤔
3
Пост от 14.09.2026 20:31
1
0
0
🐠Sakana AI представила PC-ALM - метод обучения глубоких нейросетей без классического обратного распространения ошибки.
Главный результат: PC-ALM смог обучать нейросети глубиной до 1000 слоёв, используя только локальные взаимодействия между соседними слоями.
Обычное глубокое обучение почти полностью опирается на backpropagation: ошибка считается на выходе сети, после чего градиенты передаются назад через все слои.
PC-ALM работает иначе.
Каждый слой рассматривается как локальная динамическая система, которая пытается уменьшить собственную ошибку предсказания. Вместо глобального прохода градиента используются:
- локальные ошибки предсказания
- множители Лагранжа
- расширенный лагранжиан
- локальная динамика состояний
- PI-регуляция внутри каждого слоя
Метод вырос из predictive coding — подхода, популярного в NeuroAI. В predictive coding каждый слой постепенно корректирует своё состояние так, чтобы уменьшать рассогласование с соседними слоями.
Проблема в том, что в очень глубоких сетях такие сигналы плохо распространяются: информация об ошибке с выхода сети затухает раньше, чем достигает внутренних слоёв.
PC-ALM добавляет специальные двойственные переменные — по сути дополнительные нейроны, представляющие множители Лагранжа. Они помогают передавать сигнал ошибки через большое число слоёв.
Авторы связывают этот подход с классической работой Яна Лекуна 1988 года, где множители Лагранжа для многослойной сети можно связать с градиентами функции потерь.
В результате получается обучение, где глобальная задача оптимизации раскладывается на множество локальных динамических процессов.
Особенно хорошо PC-ALM показал себя на очень глубоких и узких сетях, где обычный predictive coding начинает ломаться.
Помимо NeuroAI, подход может быть интересен для нейроморфного железа: там локальные вычисления и физическая динамика потенциально дешевле классического backpropagation на GPU.
Блог: https://pub.sakana.ai/pc-alm/
Статья: https://arxiv.org/abs/2605.31022
Код: https://github.com/SakanaAI/pc-alm
Главный результат: PC-ALM смог обучать нейросети глубиной до 1000 слоёв, используя только локальные взаимодействия между соседними слоями.
Обычное глубокое обучение почти полностью опирается на backpropagation: ошибка считается на выходе сети, после чего градиенты передаются назад через все слои.
PC-ALM работает иначе.
Каждый слой рассматривается как локальная динамическая система, которая пытается уменьшить собственную ошибку предсказания. Вместо глобального прохода градиента используются:
- локальные ошибки предсказания
- множители Лагранжа
- расширенный лагранжиан
- локальная динамика состояний
- PI-регуляция внутри каждого слоя
Метод вырос из predictive coding — подхода, популярного в NeuroAI. В predictive coding каждый слой постепенно корректирует своё состояние так, чтобы уменьшать рассогласование с соседними слоями.
Проблема в том, что в очень глубоких сетях такие сигналы плохо распространяются: информация об ошибке с выхода сети затухает раньше, чем достигает внутренних слоёв.
PC-ALM добавляет специальные двойственные переменные — по сути дополнительные нейроны, представляющие множители Лагранжа. Они помогают передавать сигнал ошибки через большое число слоёв.
Авторы связывают этот подход с классической работой Яна Лекуна 1988 года, где множители Лагранжа для многослойной сети можно связать с градиентами функции потерь.
В результате получается обучение, где глобальная задача оптимизации раскладывается на множество локальных динамических процессов.
Особенно хорошо PC-ALM показал себя на очень глубоких и узких сетях, где обычный predictive coding начинает ломаться.
Помимо NeuroAI, подход может быть интересен для нейроморфного железа: там локальные вычисления и физическая динамика потенциально дешевле классического backpropagation на GPU.
Блог: https://pub.sakana.ai/pc-alm/
Статья: https://arxiv.org/abs/2605.31022
Код: https://github.com/SakanaAI/pc-alm
Пост от 14.09.2026 17:39
5 451
51
80
🚨 Китайская Z.AI привлекла $5 млрд - и 60% средств направит на следующее поколение GLM и систему Fully Self-Training.
Финансирование состоит примерно из $2 млрд через размещение акций и $3 млрд через конвертируемые облигации.
Z.AI развивает подход, при котором каждая новая версия GLM всё больше участвует в создании среды, данных и инфраструктуры для обучения следующего поколения модели. Компания прямо связывает это направление с Recursive Self-Improvement - RSI.
GLM → строит среду и данные → обучает следующую GLM → цикл повторяется
Пока в этом процессе всё ещё много инженеров, но цель Z.AI - максимально замкнуть этот контур.
И теперь на эту идею у компании есть ещё несколько миллиардов долларов.
Финансирование состоит примерно из $2 млрд через размещение акций и $3 млрд через конвертируемые облигации.
Z.AI развивает подход, при котором каждая новая версия GLM всё больше участвует в создании среды, данных и инфраструктуры для обучения следующего поколения модели. Компания прямо связывает это направление с Recursive Self-Improvement - RSI.
GLM → строит среду и данные → обучает следующую GLM → цикл повторяется
Пока в этом процессе всё ещё много инженеров, но цель Z.AI - максимально замкнуть этот контур.
И теперь на эту идею у компании есть ещё несколько миллиардов долларов.
❤
30
🔥
21
👍
14
😁
2