Не попадитесь на накрученные каналы! Узнайте, не накручивает ли канал просмотры или
подписчиков
Проверить канал на накрутку


Телеграм канал «Чашечка Java»
Чашечка Java
7.6K
862
704
6
9.3K
Лучшие материалы по Java на русском и английском
Разместить рекламу: @tproger_sales_bot
Правила общения: https://tprg.ru/rules
Другие каналы: @tproger_channels
Разместить рекламу: @tproger_sales_bot
Правила общения: https://tprg.ru/rules
Другие каналы: @tproger_channels
Подписчики
Всего
8 338
Сегодня
-3
Просмотров на пост
Всего
587
ER
Общий
7.03%
Суточный
5.65%
Динамика публикаций

Telemetr - сервис глубокой аналитики
телеграм-каналов
телеграм-каналов

Получите подробную информацию о каждом канале
Отберите самые эффективные каналы для
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам
рекламных размещений, по приросту подписчиков,
ER, количеству просмотров на пост и другим метрикам

Анализируйте рекламные посты
и креативы
и креативы
Узнайте какие посты лучше сработали,
а какие хуже, даже если их давно удалили
а какие хуже, даже если их давно удалили

Оценивайте эффективность тематики и контента
Узнайте, какую тематику лучше не рекламировать
на канале, а какая зайдет на ура
на канале, а какая зайдет на ура

Показано 7 из 7 560 постов
Смотреть все посты
Пост от 21.10.2026 13:10
124
0
1
Spring Batch отсекает несовместимые настройки builder ещё при компиляции
Раньше некоторые взаимоисключающие настройки можно было записать в одной цепочке, а ошибку получить только на build().
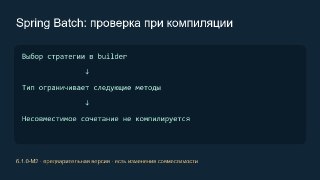
В Spring Batch 6.1.0-M2 для нескольких builder-классов ввели поэтапный DSL. После выбора одной стратегии тип возвращаемого объекта ограничивает доступные следующие методы. Некорректную комбинацию теперь отвергает компилятор.
Изменение затрагивает FlatFileItemReaderBuilder, FlatFileItemWriterBuilder и JdbcBatchItemWriterBuilder.
При миграции проверьте код, который сохраняет промежуточный результат вызова в переменную с типом builder-класса: для него есть несовместимые изменения. Непрерывным цепочкам вызовов, по описанию команды, достаточно перекомпиляции.
M2 — предварительная версия. Хороший повод проверить совместимость до финального релиза.
#java #spring #batch
Пост от 21.10.2026 08:04
42
1
1
Gradle 9.8 использует настройки зеркал репозиториев из Maven
В компании есть внутреннее зеркало зависимостей, а проекты собираются и Maven, и Gradle? В ветке Gradle 9.8 настройки зеркал можно брать из Maven вместо отдельного описания в каждой сборке.
Включается в gradle.properties:
org.gradle.mirror.maven.settings=true
По умолчанию опция выключена. После включения Gradle заменяет адреса подходящих HTTP/HTTPS Maven-репозиториев по правилам зеркал. Это касается и репозиториев сборочных скриптов, и репозиториев в настройках и проектах.
На Ivy, Maven Local, каталоги с JAR-файлами и репозитории через S3/GCS механизм не распространяется.
При обновлении выбирайте патч 9.8.1: он исправляет уязвимости и регрессии первоначального релиза.
#java #gradle
Пост от 20.10.2026 18:20
100
0
2
Java-сервер с генерацией зависимостей при сборке
Маршруты HTTP и создание компонентов можно подготовить до запуска приложения. В разборе Codename One Backend показано, как аннотации превращаются в обычные Java-классы для маршрутизации и внедрения зависимостей.
Сгенерированный код создаёт объекты прямыми вызовами конструкторов. Отсутствующие зависимости, неоднозначный выбор компонента и циклы конструкторов приводят к ошибке сборки. Затем ParparVM переводит байткод в C для нативной компиляции.
Названия аннотаций напоминают Spring, но находятся в собственном пакете com.codename1.backend.annotations. Это отдельный развивающийся проект со своим набором возможностей.
В статье есть сравнение старта и памяти с Spring Boot, однако замеры сделаны на двух простых HTTP-обработчиках без базы, TLS и авторизации. Интереснее начать с устройства сгенерированного кода, а показатели своего сервиса проверить с его реальными зависимостями.
#java #производительность
Пост от 20.10.2026 14:02
151
0
1
🔥 Почему ты получаешь отказ после «вроде норм собеса»?
Дело не всегда в знаниях. Можно знать правильный ответ, но не понимать, что именно хочет услышать интервьюер и как убедительно донести свою мысль.
Чтобы помочь с этим, ребята из ШОРТКАТ собрали 50 сложных вопросов с Java-собеседований и ответы сильного кандидата.
Они проанализировали более 100 мок-интервью и собрали в одном файле реальные вопросы и примеры ответов, на которые стоит ориентироваться при подготовке 🔥
🎁 Забирай файл бесплатно в боте 👉 @shortcut_sh_bot
А заодно сможешь зарегистрироваться на бесплатное тестовое собеседование с Java-разработчиком!
На эфире ты сможешь:
→ услышать, какие вопросы задают на собеседованиях в топовые компании;
→ посмотреть на интервью вживую;
→ лично задать вопросы ментору из бигтеха.
Забирай материалы и используй возможность подготовиться к следующему собесу 👇
@shortcut_sh_bot
Реклама.
О рекламодателе.
Пост от 20.10.2026 13:10
183
0
6
Spring AI: похожий документ ещё не содержит ответа
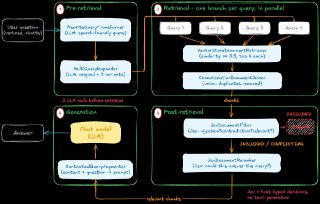
Векторный поиск нашёл текст по теме, но в ответ модели снова попала справочная информация вместо нужного факта. Для такого случая в примере Spring AI Modular RAG поиск разделён на несколько этапов.
Сначала модель переписывает вопрос для поиска и создаёт несколько его вариантов. Найденные фрагменты объединяются, после чего JevDocumentFilter отсеивает неподходящие, а JevDocumentReranker меняет порядок и оставляет лучшие.
Компоненты реализуют интерфейс DocumentPostProcessor и подключаются к RetrievalAugmentationAdvisor. Их можно менять отдельно от хранилища и модели, которая формирует ответ.
Есть полезная деталь: фильтрация и формирование контекста используют исходный вопрос пользователя. Переписанный запрос нужен только для поиска. В статье рядом лежат простая и модульная версии примера — удобно сравнить, какие фрагменты дошли до модели и почему часть была исключена.
#spring #java #rag
❤
1
Пост от 20.10.2026 08:04
149
0
2
Quarkus 4: что проверить перед миграцией
Первая бета Quarkus 4 меняет базовые зависимости сразу в нескольких частях приложения. Минимальная версия Java теперь 21, сетевой стек переходит на Netty 4.2 и Vert.x 5.
В обзоре команды также перечислены Hibernate ORM 8, Jackson 3, CDI 5.0 и Jakarta REST 4. Поэтому обновление стоит начинать с проверки расширений, сериализации и работы с базой. Для перехода подготовлено отдельное руководство.
Из новых возможностей — HTTP/3, который включается явно, и Observation API: аннотация @Observed или программный интерфейс создают метрики и трассировки через Micrometer и OpenTelemetry. В Dev UI появилась встроенная панель наблюдения.
Релиз пока тестовый. Команда просит разработчиков расширений проверять совместимость, а пользователей — прогонять приложения и сообщать о проблемах. Хорошая задача для отдельной ветки: пройти миграцию и посмотреть на поведение интеграционных тестов.
#java #quarkus
❤
1
Пост от 19.10.2026 18:20
66
0
1
Как HotSpot ускоряет криптографию внутри JDK
Реализация алгоритма написана на Java, но некоторые часто выполняемые операции JVM может заменить машинным кодом под конкретный процессор. Такой механизм называется intrinsic.
В статье команды Java он разобран на постквантовых ML-KEM, ML-DSA и HSS/LMS. У первых двух много повторяющихся операций с коэффициентами полиномов — подходящая работа для векторных инструкций. Проверка подписей HSS/LMS выигрывает от ускорения SHA-256.
Аннотация @IntrinsicCandidate отмечает методы, для которых HotSpot может применить такую замену. Java-реализация остаётся запасным вариантом, если подходящего ускорения на платформе нет.
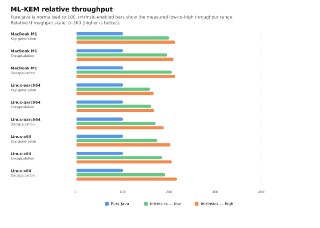
В статье приведены замеры JDK 28 на Linux/AArch64. Они сравнивают отдельные алгоритмы с включёнными intrinsics и без них. При оценке результата важны набор параметров алгоритма и возможности CPU: ускорение криптографической операции само по себе не определяет скорость всего сервиса.
#java #jvm